Kỹ thuật PEFT & LoRA: Tinh chỉnh LLM trên hạ tầng GPU hạn chế
Giải thích cập nhật hạng thấp, gradient và ngân sách VRAM của LoRA/QLoRA; chạy ví dụ Python, kiểm tra hồi quy tri thức nền và luyện review thiết kế BrSE.
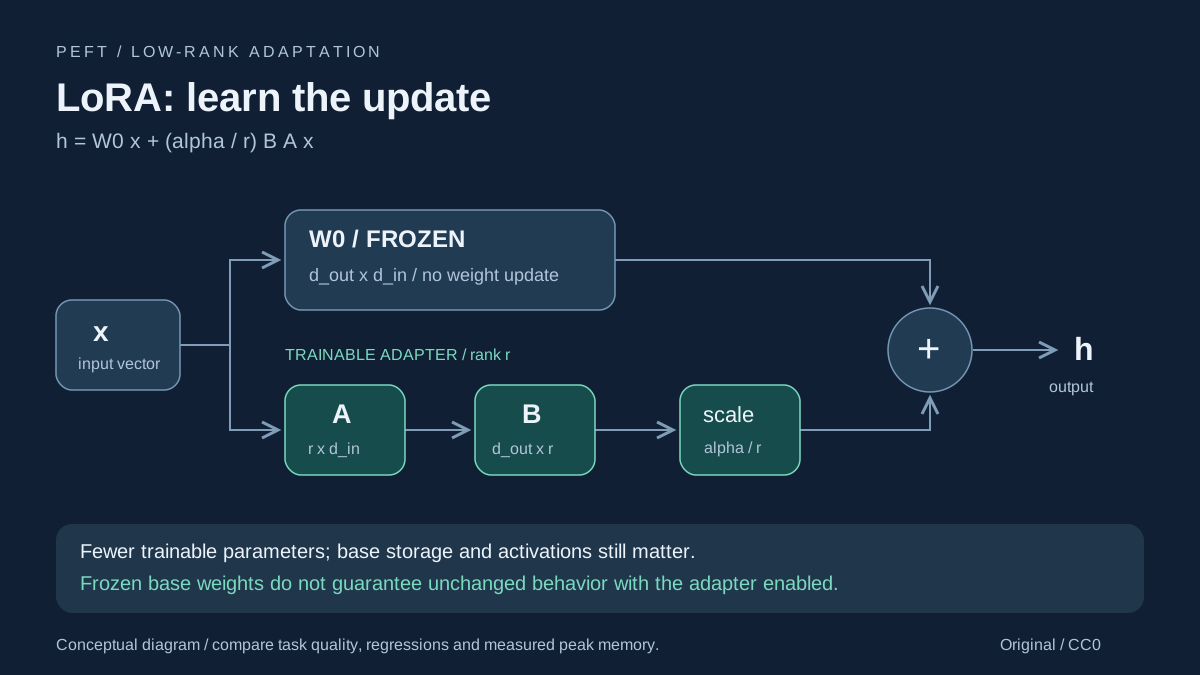
限られたGPU環境でのPEFT・LoRA:仕組みと既存能力の検証
Bối cảnh và giả định: nhóm SaaS Việt–Nhật muốn cải thiện cách LLM phân loại ticket và soạn bản nháp phản hồi Nhật–Việt. Nhóm có ngân sách GPU hạn chế, giữ chính sách hiện hành trong hệ thống truy xuất riêng và chỉ huấn luyện trên dữ liệu đã được duyệt. Trọng tâm là học hành vi chuyên biệt mà vẫn kiểm tra các năng lực cũ. Đây là tình huống tự biên soạn, không phải benchmark của một khách hàng.
Bài thuộc nhóm AI & Machine Learning, dành cho Senior Software Engineers, Tech Leads, DevOps/SRE, Solution Architects và BrSE. Cần biết phép nhân ma trận, gradient, Python và vòng training cơ bản. Phần Nhật phù hợp khoảng N3–N2; code, câu ví dụ, hội thoại và bài tập đều tự soạn.
Sau bài này, người đọc có thể:
- Giải thích LoRA học ma trận cập nhật nào, vì sao số tham số học giảm và gradient đi qua đâu.
- Phân rã ngân sách VRAM, chọn rank/target modules và phân biệt LoRA với QLoRA.
- Kiểm chứng việc giữ trọng số nền, thay đổi đầu ra và hồi quy năng lực; trao đổi điều kiện nghiệm thu bằng tiếng Nhật.
Key Takeaways: LoRA giảm phần tham số cần cập nhật, không xóa chi phí giữ model và activation. Giữ nguyên trọng số nền không đảm bảo đầu ra khi bật adapter giữ nguyên. Rank, precision, độ dài chuỗi và chất lượng dữ liệu cần được chọn bằng phép đo trên nhiệm vụ thực.
Bài Fine-tuning, RAG và ICL bàn khi nào nên đầu tư vào training. Bài này giả định đã có lý do thử fine-tuning và đi vào cơ chế cập nhật cùng điều kiện tài nguyên, không dùng LoRA thay cho việc cấp nguồn hiện hành hoặc kiểm soát quyền dữ liệu.
Hero là sơ đồ khái niệm SVG 1200×675 do BrSE.vn tự vẽ, phát hành theo CC0 1.0. Alt của hero là tiêu đề bài. Kích thước các khối không biểu diễn tỷ lệ VRAM thực nghiệm.
1. Đặt vấn đề và bối cảnh thực tế — なぜ必要なのか
Trong tình huống giả định, prompt baseline đã được đo nhưng model vẫn hay dùng sai nhãn xử lý và không giữ mẫu trả lời Nhật đã thống nhất. Nhóm muốn thử fine-tuning, song một model tải được để inference chưa chắc có thể train trên cùng GPU: backward cần trạng thái trung gian, gradient và optimizer state mà inference không có cùng cách sử dụng.
Full fine-tuning là đối chứng hợp lý khi cần khả năng điều chỉnh rộng và có tài nguyên. Giới hạn của nó xuất hiện khi mọi trọng số đều có gradient và state của optimizer, trong khi chỉ cần thích nghi một nhiệm vụ hẹp. Parameter-Efficient Fine-Tuning (PEFT) là nhóm cách thích nghi bằng một tập tham số nhỏ hơn; LoRA là một phương pháp trong nhóm đó, không phải tên gọi chung cho mọi PEFT.
Yêu cầu dự án có hai trục: kết quả mới tốt hơn, và kết quả cũ không suy giảm quá ngưỡng đã thống nhất. Không chỉ lấy training loss làm điều kiện đạt. Cần đo chất lượng phân loại, định dạng, tiếng Nhật/Việt, khả năng từ chối khi thiếu dữ kiện, peak VRAM ở workload mục tiêu, token/giây và thời gian hoàn tất một lượt thử nghiệm.
Góc nhìn BrSE: “chạy trên một GPU” phải đi cùng model revision, VRAM khả dụng, độ dài chuỗi, micro-batch và deadline. “Giữ tri thức nền” có thể nghĩa là file base không bị sửa, hoặc năng lực khi bật adapter không giảm; hai yêu cầu này cần hai phép kiểm chứng khác nhau. Chốt dữ liệu được phép train, bộ ca hồi quy, người phê duyệt và đường quay về baseline trước khi cấp tài nguyên chạy dài.
2. Bản chất kỹ thuật và cơ chế hoạt động — 仕組みを理解する
2.1. Cập nhật hạng thấp nằm bên cạnh trọng số nền
Hu và cộng sự, LoRA, mục 4.1 giữ cố định ma trận pretrained và học tích của hai ma trận nhỏ để biểu diễn cập nhật. Theo quy ước vector cột, một lớp linear không bias có thể viết:
W0: d_out x d_in        A: r x d_in        B: d_out x r
x : d_in               z = A x            s = alpha / r

h = W0 x + s B(A x)
W_effective = W0 + s B A
rank(B A) <= min(r, d_in, d_out)
W0 không nhận cập nhật optimizer; A, B là tham số trainable. Đây là rank của cập nhật, không khẳng định toàn bộ W0 là ma trận hạng thấp. Không cần dựng ma trận BA đầy đủ ở mỗi forward: tính Ax trước rồi nhân B.
Số phần tử cần học cho một ma trận là r × (d_in + d_out), so với d_in × d_out khi học toàn ma trận. Ví dụ tính tự đặt: d_in = d_out = 4096, r = 8 cho 65.536 phần tử adapter so với 16.777.216 phần tử nền, tức khoảng 0,390625%. Đây là tỷ lệ tham số của một ma trận, không phải mức giảm VRAM của toàn model.
LoRA không yêu cầu chỉ gắn vào attention. Target có thể là các projection attention hoặc linear trong MLP tùy kiến trúc; tên module và shape thực tế phải được kiểm tra. Một model có fused QKV sẽ không nhất thiết có q_proj/v_proj. Số lượng target cũng quan trọng như rank: gắn rank nhỏ vào nhiều lớp có thể có nhiều tham số hơn gắn rank lớn vào ít lớp.
2.2. Khởi tạo và gradient: vì sao không đặt cả A lẫn B bằng 0?
PEFT, tài liệu LoRA mô tả mặc định khởi tạo A theo Kaiming-uniform và B bằng 0 để nhánh cập nhật ban đầu là no-op. Paper có lựa chọn khởi tạo A riêng; điều cần kiểm chứng trong implementation là BA = 0 ở thời điểm ban đầu, cùng gradient có thể khởi động việc học.
Đạo hàm dưới đây được triển khai trực tiếp trong ví dụ tự soạn. Với g = dL/dh, z = Ax và bỏ dropout/bias:
dL/dB = s * g * z^T
dL/dA = s * (B^T g) * x^T
dL/dx = W0^T g + s * A^T B^T g
Nếu B = 0, gradient A ở lượt đầu bằng 0, nhưng gradient B có thể khác 0 nhờ Ax. Sau khi B đổi, A cũng có thể học. Nếu cả A và B đều bằng 0, hai gradient tham số cùng bằng 0 trong phép toán này: optimizer thông thường không tự tạo hướng học từ tích hai nhánh 0.
Đóng băng W0 không đồng nghĩa ngắt cả autograd qua lớp nền. Gradient theo input vẫn cần truyền ngược để học adapter ở các lớp trước. Bao toàn bộ backbone trong no_grad() một cách tùy tiện có thể làm mất đường gradient cần thiết. Đây cũng là lý do vẫn phải xem activation như một phần ngân sách training, dù không học W0.
Scaling alpha/r trong bài là LoRA thông thường. Nếu bật biến thể như rsLoRA thì quy tắc scaling khác; không đổi rank rồi giả định biên độ cập nhật và quá trình tối ưu giữ nguyên. Rank lớn hơn mở rộng không gian cập nhật nhưng không đảm bảo chất lượng tăng, nhất là khi dữ liệu ít hoặc nhãn nhiễu.
2.3. Theo dấu một training step và một bản phát hành
TRAINING / fixed base revision
approved batch -> tokenizer + labels + masks
                         |
                         v
                       input x
                         |
              +----------+----------+
              |                     |
         W0 x [frozen]       A x -> B(A x) -> scale
              |                     |
              +----------> ADD <----+
                            |
                       logits -> loss
                            |
                 backward through needed graph
                            |
              gradients + optimizer for A/B only*
                            |
                new adapter -> checkpoint/eval

* plus any explicitly configured trainable heads/biases

RELEASE
base revision + tokenizer + adapter config/weights
                    |
             task + regression gates
                    |
       serve unmerged OR export merged candidate
                    |
          verify / release / rollback
Trong một step của thiết kế đề xuất, dữ liệu đi qua forward, loss và backward; optimizer chỉ được nhận tập tham số đã kiểm tra requires_grad. Khi dùng accumulation, gradient được tích lũy qua nhiều micro-batch trước một optimizer step; label mask, cách chuẩn hóa loss và số token hữu ích phải nhất quán. Padding nhiều có thể tốn bộ nhớ nhưng không tăng dữ liệu học hữu ích.
Base, tokenizer, chat template, target modules, rank, alpha, dtype và dữ liệu phải có version trong manifest thí nghiệm. Adapter checkpoint nhỏ không đủ tự chạy nếu thiếu base tương thích. Muốn resume đúng tiến trình tối ưu còn cần optimizer/scheduler state, bước hiện tại và trạng thái ngẫu nhiên theo thiết lập; chỉ nạp A/B không tự tái hiện một lần training bị gián đoạn.
2.4. VRAM: giảm optimizer state không làm biến mất activation
Hugging Face, GPU memory usage phân biệt model weights, optimizer states, gradients, activation và temporary tensors. Mô hình ngân sách tự lập cho một thiết lập một GPU trong bài là:
peak_memory ≈ frozen_base_storage
            + adapter_weights + adapter_gradients + optimizer_states
            + saved_activations + temporary_workspaces
            + runtime/allocator_overhead
Các số hạng phụ thuộc dtype, optimizer, checkpointing, attention backend và placement; đây là khung dự toán, không phải phép đo chính xác. Ví dụ tự tính: 7 tỷ phần tử lưu thuần 16-bit cần khoảng 14 GB thập phân, tương đương khoảng 13,04 GiB. Nếu thuần 4-bit thì payload lý tưởng khoảng 3,5 GB, nhưng chưa tính scale/metadata, tensor giữ precision khác và workspace. Không dùng hai con số này làm cam kết model sẽ train vừa GPU có dung lượng tương ứng.
LoRA thường tiết kiệm mạnh ở gradient/optimizer của trọng số nền. Nếu còn train embedding hoặc output head, phải cộng riêng số tham số đó. Với Adam có hai state FP32, ví dụ giả định riêng state là 8 × số tham số trainable byte; cách lưu weights, master copy và gradient cần đọc cấu hình thực tế, không lấy một hằng số byte/parameter cho mọi stack.
Khi OOM tăng theo độ dài chuỗi hoặc micro-batch, giảm rank có thể không chạm đúng phần gây đỉnh. Thử giảm micro-batch/sequence length, giảm padding và dùng activation checkpointing nếu stack hỗ trợ; checkpointing đổi bộ nhớ lưu trung gian lấy tính toán lại. Gradient accumulation có thể giữ effective batch lớn trong khi giảm micro-batch, nhưng không xóa weights, optimizer state hoặc thay thế kiểm chứng learning dynamics.
2.5. QLoRA: lượng tử hóa base và vẫn học adapter
Dettmers và cộng sự, QLoRA truyền gradient qua backbone pretrained được đóng băng và lượng tử hóa 4-bit tới LoRA adapter. Paper giới thiệu NF4, double quantization và paged optimizers trong thiết lập nghiên cứu. Đây là cơ chế và kết quả của nghiên cứu, không phải đảm bảo mọi model/sequence length sẽ vừa một GPU bất kỳ.
Trọng số lưu 4-bit không có nghĩa mọi phép tính hoặc tensor training đều 4-bit. Hướng dẫn quantization của PEFT tách cấu hình lưu base, compute dtype, bước prepare_model_for_kbit_training() và thêm adapter. Dtype compute phải phù hợp hardware; không bật bfloat16 chỉ vì một mẫu cấu hình dùng nó.
QLoRA giảm storage của base bên cạnh lợi ích của LoRA; đồng thời thêm phụ thuộc vào backend quantization, kernel và cách xuất bản model. Cần đo chênh lệch chất lượng giữa base gốc, base lượng tử hóa và bản có adapter. Không quy mọi thay đổi chất lượng cho LoRA khi đồng thời đổi precision.
2.6. Bảo toàn tri thức: tách ba yêu cầu có thể kiểm chứng
Một là giữ artifact nền: so sánh revision/hash hoặc tensor trước–sau training, kiểm tra base không nằm trong optimizer. Điều này chứng minh không sửa artifact W0 theo cách đã kiểm tra.
Hai là khôi phục baseline khi tắt adapter: với cấu hình chỉ học LoRA, không có bias/head ngoài adapter bị sửa, cùng precision và pipeline, tắt adapter phải quay về đường nền. Nếu đã đổi tokenizer, lượng tử hóa base hoặc train modules_to_save, phép so cần tính cả các thay đổi ấy. “Tắt LoRA” không nhất thiết khôi phục một cấu hình khác ban đầu.
Ba là năng lực khi bật adapter: kiểm tra bộ ca riêng về Nhật/Việt, nghiệp vụ cũ, xử lý phủ định, thiếu nguồn và các ràng buộc quan trọng. W0 không đổi nhưng tổng W0 + sBA đổi, nên câu trả lời có thể khác. Ví dụ tuyến tính bên dưới cho phản ví dụ cụ thể, không chứng minh tỷ lệ quên tri thức của một LLM.
Thiết kế nghiệm thu đề xuất đánh giá hai trục: điểm nhiệm vụ mới và mức hồi quy trên từng nhóm quan trọng. Chọn rank/learning rate/số bước theo dev set; test giữ kín chỉ dùng ở bước chốt. Dữ liệu chất lượng, early stopping và bộ ca tổng quát hoặc dữ liệu ôn tập đã được phép dùng là các biện pháp cần thử, không phải bằng chứng bảo toàn tự động. Các ca nghiêm trọng phải có ngưỡng riêng; điểm trung bình có thể che một nhóm bị suy giảm.
2.7. Merge và phục vụ
Ở lớp linear, có thể tính Wmerged = W0 + sBA rồi chỉ dùng một phép linear khi inference. Implementation tham chiếu microsoft/LoRA có cơ chế merge/unmerge; API vòng đời cụ thể khác thư viện PEFT. Không trộn hướng dẫn của hai implementation trong cùng một quy trình phục vụ.
Đẳng thức áp dụng cho cấu hình tuyến tính tương ứng khi không có dropout training làm thay đổi đường tính. Khi export sang dtype hoặc quantization khác, round-off có thể làm output không giống tuyệt đối. Giữ base gốc và adapter riêng làm artifact; kiểm tra output/logits trong tolerance đã chốt, chất lượng, latency và bộ nhớ của bản merged thực tế. Không coi trừ adapter khỏi một file đã merge/quantize là phương án backup đáng tin thay cho giữ artifact gốc.
LoRAでは、基盤モデルの重みを固定し、小さな行列を学習します。ただし、中間結果を保存するメモリは必要です。重みが変わらなくても、アダプターを有効にした場合の回答は変わる可能性があります。新しい業務の精度だけでなく、既存の能力も検証します。
Dịch: Trong LoRA, chúng tôi cố định trọng số của model nền và học các ma trận nhỏ. Tuy vậy, vẫn cần bộ nhớ lưu kết quả trung gian. Dù trọng số nền không đổi, câu trả lời khi bật adapter vẫn có thể thay đổi. Chúng tôi kiểm chứng cả năng lực hiện có, bên cạnh độ chính xác của nghiệp vụ mới.
Phân tích câu: ただし bổ sung giới hạn cho lợi ích vừa nêu, không phủ nhận rằng LoRA giảm tham số học. Trong câu ba, “trọng số không đổi” chỉ trọng số nền của câu đầu; 場合 giới hạn phát biểu ở trạng thái bật adapter. だけでなく~も ghép hai phần nghiệm thu bắt buộc, không biến “năng lực nền” thành điều đã được đảm bảo.
3. Hiện thực hóa kỹ thuật — 実装する
3.1. Môi trường và cách chạy
Phần thực thi chính dùng Python 3.11 trở lên, chỉ standard library, không tải model và không cần GPU. File duy nhất là lora_linear.py; chép trọn code mục 3.3 rồi chạy:
python3 --version
python3 lora_linear.py
Đây là LoRA rank 1 trên một lớp linear 2×3 với gradient được tính trực tiếp. Nó kiểm tra phép toán học adapter và phản ví dụ hồi quy, không phải training một LLM. A có ba phần tử và B có hai; kích thước nhỏ phục vụ quan sát, không dùng mức tiết kiệm của lớp đồ chơi để dự toán GPU.
Kết quả mong đợi: gradient số và gradient giải tích khớp trong tolerance; loss giảm; W0 giữ nguyên; merge tương đương forward có adapter; đầu ra holdout đổi khi bật và trở về baseline khi tắt; các đầu vào sai bị từ chối.
3.2. Cách triển khai ban đầu
Full update trên cùng lớp tuyến tính có thể viết trực tiếp như sau:
def full_step(
    weights: list[list[float]], x: list[float], y: list[float], lr: float,
) -> list[list[float]]:
    if len(weights) != len(y) or any(len(row) != len(x) for row in weights):
        raise ValueError("incompatible dimensions")
    predictions = [sum(w * v for w, v in zip(row, x)) for row in weights]
    return [
        [w - lr * (p - target) * v for w, v in zip(row, x)]
        for row, p, target in zip(weights, predictions, y)
    ]
Hàm minh họa gradient của loss 0.5 × tổng bình phương lỗi, dùng SGD và cập nhật toàn bộ W. Nó phù hợp cho lớp nhỏ này; với LLM và optimizer có state, số tham số phải học là điểm cần xem xét. Phần cải tiến giữ W0 và chỉ tối ưu hai nhánh nhỏ; không giả định full fine-tuning là một lựa chọn sai trong mọi bối cảnh.
3.3. Cách triển khai cải tiến
Code tự đặt W0, A khởi tạo khác 0 và B bằng 0; không dùng random để kết quả dễ tái lập. enabled=False chọn đúng đường nền. merged() tạo ma trận mới, không ghi đè w0.
from __future__ import annotations

from math import isclose, isfinite
from typing import Callable


def checked(values: list[float], size: int) -> None:
    if len(values) != size or not all(isfinite(v) for v in values):
        raise ValueError("invalid shape or non-finite input")


class RankOneLinear:
    def __init__(self, alpha: float = 2.0) -> None:
        if not isfinite(alpha) or alpha <= 0:
            raise ValueError("alpha must be finite and positive")
        self.w0 = ((1.0, 0.0, 0.0), (0.0, 1.0, 0.0))
        self.a = [0.2, 0.4, 0.0]  # A: 1 x 3; cố định seed bằng giá trị tự đặt.
        self.b = [0.0, 0.0]       # B: 2 x 1; delta ban đầu bằng 0.
        self.scale = alpha        # alpha / r, với r = 1.

    def forward(self, x: list[float], enabled: bool = True) -> list[float]:
        checked(x, 3)
        z = sum(a * v for a, v in zip(self.a, x))
        return [
            sum(w * v for w, v in zip(row, x))
            + (self.scale * self.b[i] * z if enabled else 0.0)
            for i, row in enumerate(self.w0)
        ]

    def loss(self, x: list[float], y: list[float]) -> float:
        checked(y, 2)
        return 0.5 * sum((p - t) ** 2 for p, t in zip(self.forward(x), y))

    def gradients(self, x: list[float], y: list[float]) -> tuple[list[float], list[float]]:
        checked(y, 2)
        error = [p - t for p, t in zip(self.forward(x), y)]
        z = sum(a * v for a, v in zip(self.a, x))
        da = [self.scale * sum(b * e for b, e in zip(self.b, error)) * v for v in x]
        db = [self.scale * e * z for e in error]
        return da, db

    def step(self, x: list[float], y: list[float], lr: float) -> None:
        if not isfinite(lr) or lr <= 0:
            raise ValueError("learning rate must be finite and positive")
        da, db = self.gradients(x, y)  # Tính cả hai từ cùng trạng thái cũ.
        self.a = [v - lr * g for v, g in zip(self.a, da)]
        self.b = [v - lr * g for v, g in zip(self.b, db)]

    def merged(self) -> tuple[tuple[float, ...], ...]:
        return tuple(
            tuple(w + self.scale * self.b[i] * a for w, a in zip(row, self.a))
            for i, row in enumerate(self.w0)
        )


def gradient_check() -> None:
    model = RankOneLinear()
    model.b = [0.1, -0.2]  # Kiểm cả gradient A và B ở trạng thái khác 0.
    x, y = [1.0, 0.5, -0.3], [1.4, 0.1]
    da, db = model.gradients(x, y)
    eps = 1e-6
    for values, expected in ((model.a, da), (model.b, db)):
        for j, analytical in enumerate(expected):
            old = values[j]
            values[j] = old + eps
            plus = model.loss(x, y)
            values[j] = old - eps
            minus = model.loss(x, y)
            values[j] = old
            numerical = (plus - minus) / (2 * eps)
            assert isclose(analytical, numerical, abs_tol=1e-8, rel_tol=1e-6)
    print("gradient_check: passed")


def expect_invalid(label: str, operation: Callable[[], object]) -> None:
    try:
        operation()
    except ValueError:
        print(label + ": rejected")
    else:
        raise AssertionError(label + " should fail")


def main() -> None:
    gradient_check()
    model = RankOneLinear()
    original = model.w0
    x, target = [1.0, 0.0, 0.0], [1.6, -0.3]
    holdout = [0.0, 1.0, 0.0]
    base_holdout = model.forward(holdout, enabled=False)
    assert model.forward(x) == model.forward(x, enabled=False)
    da, db = model.gradients(x, target)
    assert all(g == 0 for g in da) and any(g != 0 for g in db)
    initial = model.loss(x, target)
    for _ in range(300):
        model.step(x, target, lr=0.08)
    final = model.loss(x, target)
    assert final < 1e-10 and final < initial
    assert model.w0 == original
    active_holdout = model.forward(holdout)
    assert max(abs(a - b) for a, b in zip(active_holdout, base_holdout)) > 0.05
    assert model.forward(holdout, enabled=False) == base_holdout
    for probe in (x, holdout, [0.2, -0.5, 0.7]):
        merged_out = [sum(w * v for w, v in zip(row, probe)) for row in model.merged()]
        assert all(isclose(a, b, abs_tol=1e-12) for a, b in zip(merged_out, model.forward(probe)))
    stuck = RankOneLinear()
    stuck.a = [0.0, 0.0, 0.0]
    stuck.step(x, target, lr=0.08)
    assert stuck.a == [0.0, 0.0, 0.0] and stuck.b == [0.0, 0.0]
    assert stuck.loss(x, target) == initial
    print(f"training_loss: {initial:.6f} -> {final:.12f}")
    print("base_unchanged: passed; merge_equivalence: passed; zero_init_trap: passed")
    print("holdout_base:", base_holdout, "holdout_adapter:", [round(v, 6) for v in active_holdout])
    print("adapter_disabled: restores base output")
    expect_invalid("bad_shape", lambda: model.forward([1.0]))
    expect_invalid("non_finite", lambda: model.forward([float("nan"), 0.0, 0.0]))
    expect_invalid("bad_target", lambda: model.loss(x, [1.0]))
    expect_invalid("bad_lr", lambda: model.step(x, target, 0.0))
    expect_invalid("bad_alpha", lambda: RankOneLinear(0.0))
    print("all LoRA checks passed")


if __name__ == "__main__":
    main()
Gradient được tính từ cùng trạng thái cũ rồi mới cập nhật A/B. Nếu cập nhật B trước khi tính gradient A của cùng step, ta đã đổi thuật toán so với công thức đang kiểm tra. gradient_check() dùng sai phân trung tâm ở trạng thái B khác 0 để kiểm cả hai nhánh; chỉ kiểm tại B=0 sẽ không đủ để phát hiện nhiều lỗi trong gradient A.
w0 là tuple bất biến và không có trong step(). Trong PyTorch/PEFT, thuộc tính bất biến không được suy từ kiểu tuple; cần kiểm tra requires_grad, param groups và tensor sau optimizer step. Bộ test “A/B đều 0” ở đây chủ động tạo một cấu hình sai để chứng minh vì sao nó không học.
Demo chạy đồng bộ trong CPU, không có request mạng, retry hoặc timeout ngoài. Nó không cấp secret, không ghi checkpoint model và không đo VRAM. Lỗi shape/non-finite/learning rate không hợp lệ được trả rõ; không tự thử lại một phép tính không đúng đầu vào. Vòng training thật cần dừng khi loss/gradient không hữu hạn, lưu metadata để điều tra và khởi động lại từ checkpoint được xác minh thay vì nuốt lỗi.
Cầu nối sang PEFT — chỉ cấu hình, chưa chạy: tài liệu đọc trong lượt này chuyển tới PEFT v0.21.0. Hàm sau dùng API cấu hình từ tài liệu ấy cho một PreTrainedModel causal LM đã được người chạy nạp và xác minh. Nó không tải model, không có trainer/dataloader và không phải script training GPU hoàn chỉnh:
from peft import LoraConfig, TaskType, get_peft_model
from transformers import PreTrainedModel


def attach_lora(base_model: PreTrainedModel):
    targets = ("q_proj", "v_proj")
    names = tuple(name for name, _ in base_model.named_modules())
    if not all(any(name.endswith(target) for name in names) for target in targets):
        raise ValueError("inspect this architecture before selecting target_modules")
    config = LoraConfig(
        task_type=TaskType.CAUSAL_LM,
        r=8,
        lora_alpha=16,
        lora_dropout=0.05,
        target_modules=list(targets),
        bias="none",
        use_rslora=False,
    )
    adapted = get_peft_model(base_model, config)
    adapted.print_trainable_parameters()
    return adapted
Các giá trị rank/alpha/dropout ở đây là ứng viên để thử, không phải cấu hình đã tối ưu cho dự án. Trước khi áp dụng phải kiểm tra lớp target có kiểu/shape được hỗ trợ, liệt kê mọi tham số trainable và xác minh optimizer chỉ nhận đúng tập đó. Kiểm tra tên trong hàm chưa đủ chứng minh module phù hợp. Với model quantized, đọc quy trình chuẩn bị k-bit của stack đang dùng trước khi gắn adapter; không chỉ thêm cờ 4-bit vào hàm trên.
Phần PEFT chưa được thực thi vì môi trường hiện tại không có torch/peft; không có GPU training nào được xác nhận. Để dùng thực tế, chuẩn bị môi trường riêng với PyTorch/CUDA/backend và PEFT tương thích, khóa phiên bản đã kiểm thử, nạp base/tokenizer revision được duyệt, chuẩn bị labels/loss mask và trainer, chạy một step nhỏ rồi mới tăng tải. Không cài các dependency đó vào blog.
3.4. Cách kiểm chứng
Các bước kiểm tra local đã được viết ngay trong main():
| Phép thử | Điều kiện đạt | Ý nghĩa và giới hạn |
|---|---|---|
| Gradient check | Sai phân và đạo hàm khớp trong tolerance | Kiểm đạo hàm A/B của lớp nhỏ |
| Khởi tạo | Forward có/tắt adapter giống nhau ban đầu | Delta bằng 0, chưa kết luận về mọi pipeline LLM |
| Khởi động học | Gradient A bằng 0, B khác 0 ở lượt đầu | Kiểm cơ chế khởi tạo được dùng |
| Tối ưu 300 bước | Loss dưới 1e-10, W0 không đổi |
Học một mẫu tổng hợp, không đo tổng quát hóa |
| Holdout | Đầu ra active khác base hơn 0,05 ở ít nhất một tọa độ | Phản ví dụ cho “base frozen thì đầu ra không đổi” |
| Tắt adapter | Khôi phục đầu ra base đúng của demo | Không có bias/head khác bị train |
| Merge | Khớp ở ba probe với tolerance 1e-12 |
Kiểm đẳng thức tuyến tính trong precision Python |
| Khởi tạo cả hai bằng 0 | A/B không đổi sau step, loss đứng yên | Chủ động kiểm cạm bẫy gradient |
| Đầu vào lỗi | Shape, NaN, target, learning rate, alpha bị từ chối | Các ca lỗi local, không phải kiểm tra toàn stack |
Các ngưỡng trong bảng là assertion của bài tập, không phải SLO cho LLM. Kết quả thực thi thật được ghi ở cuối bài.
Với GPU, đo ba mốc: sau nạp base, sau gắn adapter/tạo optimizer, và đỉnh qua forward–backward–optimizer của nhiều step. Optimizer có thể tạo state muộn ở step đầu, nên không dùng footprint lúc mới load làm peak training. Khóa seed, precision, sequence length, micro-batch, accumulation và attention backend khi so sánh.
PyTorch có max_memory_allocated cho đỉnh bộ nhớ tensor cấp phát và max_memory_reserved cho đỉnh vùng allocator giữ. Reset thống kê tại ranh giới đo đã chọn, synchronize khi cần đo thời gian CUDA và báo cả cách warm-up. Các metric này không tự đại diện mọi cấp phát của toàn GPU hay tiến trình khác; đối chiếu thêm quan sát thiết bị. Bài chưa chạy các phép đo GPU này.
Đánh giá chất lượng phải có base, base+adapter, và nếu có quantization thì thêm base quantized cùng cấu hình. Chạy task test và regression suite theo nhóm quan trọng, không chỉ đọc một câu trả lời đẹp. Nếu candidate mới tăng điểm task nhưng vượt ngưỡng hồi quy, giữ nó ở trạng thái chưa phát hành. Khi cần merge/export, chạy lại chất lượng và tolerance trên artifact xuất thật.
4. Cạm bẫy thực tế và đánh đổi — 注意点とトレードオフ
4.1. Giảm tham số nhưng vẫn OOM
Triệu chứng: số trainable rất nhỏ nhưng backward ở chuỗi dài vẫn hết VRAM. Nguyên nhân: activation, workspace, độ dài batch có padding hoặc base storage mới là phần chi phối. Phát hiện: log chiều dài token thực, peak qua từng pha và param groups; so micro-batch/sequence length có kiểm soát. Khắc phục: giảm micro-batch, giới hạn độ dài hợp lý, gom mẫu theo chiều dài, thử checkpointing và quantization nếu phù hợp. Đánh đổi: giảm context có thể mất thông tin; checkpointing thêm tính toán; quantization đổi môi trường và có thể đổi chất lượng. Không hạ rank vô hạn rồi coi vấn đề đã được xử lý.
4.2. Adapter không học hoặc học sai module
Triệu chứng: loss đứng yên, gradient A/B luôn 0, hoặc trainable count khác dự toán. Nguyên nhân: A/B đều khởi tạo 0, target name không khớp, đường graph bị ngắt hoặc vô tình train head lớn. Phát hiện: kiểm một batch nhỏ, in tên/shape/gradient norm của tham số, so forward trước bước đầu. Khắc phục: xác minh initialization, target modules, loss mask và optimizer; giữ một bài thử gradient/one-step. Đánh đổi: thêm công việc chẩn đoán theo kiến trúc, không thể dùng một danh sách tên module cho mọi model.
4.3. Nghiệp vụ mới tốt hơn nhưng năng lực cũ giảm
Triệu chứng: nhãn mới đúng hơn nhưng tiếng Nhật, phủ định hoặc ca từ chối cũ bị sai. Nguyên nhân: dữ liệu lệch/nhiễu, nhiều bước hoặc cập nhật làm thay đổi đường dự đoán trên nhóm ngoài task. W0 frozen chưa ngăn sBAx ảnh hưởng các input đó. Phát hiện: regression suite riêng, đánh giá theo nhóm, so base và candidate với cùng generation config. Khắc phục: cải thiện dữ liệu, thử giảm learning rate/số bước/rank hoặc thay target, dùng early stopping; cân nhắc dữ liệu ôn tập đã duyệt. Đánh đổi: thêm dữ liệu/compute và có thể giảm lợi ích trên task mới. Chỉ phát hành khi cả hai trục đạt ngưỡng đã chốt.
4.4. Nạp nhầm base hoặc xuất bản merged chưa kiểm tra
Triệu chứng: adapter chạy được nhưng chất lượng khác lần nghiệm thu, hoặc output merged lệch quá tolerance. Nguyên nhân: base/tokenizer revision khác, scale/target config không khớp, dtype/quantization thay đổi hoặc artifact bị merge hai lần. Phát hiện: manifest/hash, bài thử load round-trip và probe logits/output trước–sau export. Khắc phục: ràng buộc adapter với đúng base/tokenizer/config, export thành candidate mới, giữ bản gốc bất biến và rollback bằng artifact đã kiểm chứng. Đánh đổi: thêm lưu trữ và quy trình phát hành; adapter nhỏ không loại bỏ chi phí quản lý vòng đời.
| Phương án | Bộ nhớ và hiệu năng | Chi phí | Độ phức tạp | Độ tin cậy/vận hành | Khi nên thử |
|---|---|---|---|---|---|
| Full fine-tuning | Học nhiều tham số; gradient/state lớn hơn nếu cùng optimizer/dtype | Compute/checkpoint có thể lớn | Serving một checkpoint; training cần tài nguyên | Không gian điều chỉnh rộng, vẫn phải đo hồi quy | Nhiệm vụ cần cập nhật rộng, đủ dữ liệu và tài nguyên |
| LoRA trên base 16-bit | Giảm phần tham số học; base và activation vẫn chiếm VRAM | Adapter nhỏ; vẫn trả chi phí forward/backward qua backbone | Target/rank và liên kết base–adapter | Dễ giữ base riêng, không tự bảo toàn output active | Base vừa máy, cần thích nghi nhiệm vụ hẹp |
| QLoRA | Giảm storage base; compute/activation không đồng loạt 4-bit | Có thể mở thêm cấu hình vừa bộ nhớ; phải đo thời gian thực | Quantization backend, dtype, export | Cần tách hồi quy do quantization và adapter | Base precision cao chưa vừa budget, stack hỗ trợ |
| LoRA + activation checkpointing | Giảm lượng activation lưu, có tính toán lại | Thường đổi VRAM lấy thêm compute | Tương thích graph/checkpointing | Cần kiểm gradient và khả năng resume | Peak do activation chi phối |
Đây là so sánh định tính theo thành phần, không phải benchmark. Với dự án giả định, thử rank nhỏ trên target đã xác minh, đo một step rồi một lượt pilot; chỉ thêm quantization/checkpointing khi biết phần nào đang vượt budget. Không cam kết “GPU ít VRAM vẫn train mọi model” hoặc “rank lớn luôn giữ nhiều tri thức hơn”.
5. Checklist trước khi triển khai — 本番環境への適用前チェック
- Có baseline task và regression suite giữ kín, ngưỡng đạt riêng cho Nhật/Việt, nghiệp vụ cũ và ca thiếu dữ kiện.
- Dataset được duyệt, chia train/dev/test không lẫn mẫu; label/loss mask đã kiểm trên batch thật.
- Liệt kê trainable parameters, target shapes, rank, alpha, dtype; base không nằm trong optimizer nếu yêu cầu đóng băng.
- Đo peak training qua optimizer step, log sequence length/micro-batch/accumulation và điều kiện warm-up; không lấy model footprint làm peak.
- Lưu base/tokenizer/prompt/adapter revision, config và trạng thái cần resume; có kiểm tra reload và rollback.
- Khi dùng quantization/merge, kiểm riêng thay đổi do precision, tolerance và chất lượng của artifact xuất thật.
- Chốt giới hạn GPU/time/cost và cả hai trục nghiệm thu với khách hàng; chưa đạt hồi quy thì chưa phát hành.
6. Học tiếng Nhật qua chủ đề — 技術日本語を学ぶ
6.1. Sổ tay thuật ngữ kỹ thuật và giao tiếp BrSE
Hán Việt dùng để nhớ chữ; từ thuần Nhật/katakana không ép ghép âm. Các ví dụ theo đúng quyết định giữ base, học adapter và đo hồi quy.
| Thuật ngữ Nhật | Furigana | Hán Việt | Nghĩa tiếng Việt / English | Câu ví dụ Nhật | Dịch nghĩa |
|---|---|---|---|---|---|
| 低ランク | ていランク | - | Hạng thấp / low rank | 低ランクの更新を学習します。 | Học cập nhật hạng thấp. |
| 行列 | ぎょうれつ | Hành liệt | Ma trận / matrix | 二つの行列の積で更新を表します。 | Biểu diễn cập nhật bằng tích hai ma trận. |
| 重み | おもみ | - | Trọng số / weight | 基盤モデルの重みは固定します。 | Cố định trọng số của model nền. |
| 固定 | こてい | Cố định | Cố định; đóng băng / freeze | 固定した部分も計算に使います。 | Phần đóng băng vẫn được dùng trong tính toán. |
| 勾配 | こうばい | Câu phối | Gradient; độ dốc | 勾配がゼロかどうかを確認します。 | Kiểm tra gradient có bằng 0 hay không. |
| 中間結果 | ちゅうかんけっか | Trung gian kết quả | Kết quả trung gian / intermediate result | 中間結果の保存にもメモリを使います。 | Cũng dùng bộ nhớ để lưu kết quả trung gian. |
| 量子化 | りょうしか | Lượng tử hóa | Quantization | 量子化による影響を分けて測定します。 | Đo riêng ảnh hưởng của quantization. |
| 既存能力 | きそんのうりょく | Ký tồn năng lực | Năng lực hiện có / existing capability | 既存能力も検証します。 | Cũng kiểm chứng năng lực hiện có. |
| 劣化 | れっか | Liệt hóa | Suy giảm / degradation | 特定の業務で劣化がないか調べます。 | Kiểm tra xem có suy giảm ở nghiệp vụ cụ thể không. |
| 検証 | けんしょう | Kiểm chứng | Kiểm chứng / verification | 保存後のモデルを再読込みして検証します。 | Nạp lại model sau khi lưu để kiểm chứng. |
| アダプター | アダプター | - | Bộ thích nghi / adapter | アダプターを無効にして比較します。 | Tắt adapter để so sánh. |
| 受入条件 | うけいれじょうけん | - | Điều kiện nghiệm thu / acceptance criteria | 受入条件を先に決めます。 | Xác định điều kiện nghiệm thu trước. |
Cặp dễ nhầm: 固定 mô tả tham số không được cập nhật, còn 保持 là giữ lại, cần nói rõ giữ artifact hay giữ năng lực. 精度向上 là cải thiện chất lượng/độ chính xác theo metric; 劣化防止 là tránh suy giảm, không phải điều tự xảy ra khi giảm số tham số học. 検証済み chỉ dùng cho phạm vi thật sự đã chạy, như phép toán linear ở đây, không mở rộng thành “LLM đã được kiểm chứng”.
6.2. Ngữ pháp và mẫu diễn đạt
Các mẫu phục vụ review khoảng N3–N2, không gán cấp JLPT chính thức.
| Mẫu | Ý nghĩa | Ví dụ |
|---|---|---|
| ~まま | Giữ nguyên trạng thái | 重みを固定したまま学習します。— Học trong khi giữ trọng số nền đóng băng. |
| ~とは限らない | Không nhất thiết | 劣化しないとは限りません。— Chưa chắc không suy giảm. |
| ~だけでなく~も | Không chỉ… mà còn… | 精度だけでなくメモリも測定します。— Đo cả chất lượng lẫn bộ nhớ. |
| ~た上で | Sau khi hoàn tất bước tiền đề | 検証した上で公開します。— Phát hành sau khi kiểm chứng. |
1. ~まま
Cấu trúc: động từ thể た + まま, danh từ + のまま, mô tả duy trì trạng thái trong khi việc khác diễn ra. Trong review, dùng để nêu điều kiện cố định khi training/đo; cần nói rõ đối tượng nào giữ nguyên.
- 基盤モデルの重みを固定したまま、アダプターを学習します。— Học adapter trong khi giữ trọng số model nền cố định.
- 入力長を同じにしたまま、ランクを変えて比較します。— Giữ cùng độ dài đầu vào và thay rank để so sánh.
Đừng hiểu “giữ trọng số nền” thành “giữ nguyên mọi đầu ra”: chủ thể của trạng thái phải được chỉ rõ. Trong tài liệu, ghi cả precision và adapter đang bật hay tắt.
2. ~とは限らない
Cấu trúc: mệnh đề thông thường + とは限らない. Phủ nhận tính tất yếu; khi mệnh đề bên trong đã phủ định, cần dịch cẩn thận. Dùng để nêu quan ngại có điều kiện thay vì cam kết vượt bằng chứng.
- 重みを固定しても、既存能力が劣化しないとは限りません。— Dù đóng băng trọng số nền, chưa chắc năng lực cũ không suy giảm.
- ランクを上げれば、精度が上がるとは限りません。— Tăng rank chưa chắc làm chất lượng tăng.
Không dịch câu đầu thành “chắc chắn suy giảm”. Nó chỉ nói không thể đảm bảo không suy giảm; bước tiếp theo là kiểm thử hồi quy, không phải kết luận mọi LoRA đều thất bại.
3. ~だけでなく~も
Cấu trúc: A + だけでなく + B + も. Nhấn mạnh phải xem thêm B ngoài A; thích hợp liệt kê hai trục nghiệm thu. A và B nên có cấu trúc ngữ pháp tương ứng để rõ điều đang so sánh.
- 新しい業務だけでなく、既存の業務もテストします。— Kiểm thử cả nghiệp vụ cũ bên cạnh nghiệp vụ mới.
- 平均値だけでなく、最大使用量も報告します。— Báo cả mức sử dụng cao nhất bên cạnh giá trị trung bình.
Tránh nói “đo cả bộ nhớ” nhưng chỉ ghi footprint lúc load: cần nêu rõ là peak của pha nào. Mẫu ngữ pháp nối hai mục, không tự định nghĩa phép đo.
4. ~た上で
Cấu trúc: động từ thể た + 上で, đặt bước đầu làm tiền đề cho quyết định sau. Dùng với khách hàng khi chốt chỉ phát hành sau đánh giá, khác ~上に mang nghĩa bổ sung đặc điểm/lý do.
- 回帰テストを実施した上で、採用を判断します。— Quyết định áp dụng sau khi thực hiện regression test.
- 保存したモデルを再検証した上で、公開します。— Phát hành sau khi kiểm chứng lại model đã lưu.
“Thực hiện test” chưa tự nói test đạt; nếu là điều kiện phát hành, câu kế tiếp hoặc đặc tả phải ghi ngưỡng pass và người phê duyệt.
6.3. Luyện tập ngắn
- Điền mẫu giữ trạng thái: 基盤モデルを固定した( )、アダプターを学習します。
- Dịch Việt → Nhật: “Chúng tôi kiểm chứng cả năng lực cũ bên cạnh độ chính xác của nghiệp vụ mới.”
- Sửa câu quá khẳng định và thêm bước tiếp theo: LoRAなら、既存の知識は絶対に失われません。— “Nếu dùng LoRA thì tuyệt đối không mất tri thức cũ.”
Đáp án và giải thích:
まま: 基盤モデルを固定したまま、アダプターを学習します。— Học adapter trong khi giữ model nền cố định. Điều cố định là tham số nền, không phải kết quả có adapter.- 新しい業務の精度だけでなく、既存の能力も検証します。— Kiểm chứng cả năng lực cũ bên cạnh độ chính xác của nghiệp vụ mới. Hai trục phải có ca kiểm thử tương ứng.
- LoRAでも、既存能力が劣化しないとは限りません。回帰テストで確認します。— Dù dùng LoRA, chưa chắc năng lực cũ không suy giảm. Chúng tôi xác nhận bằng regression test. Câu sửa bỏ cam kết tuyệt đối và nêu phép kiểm cụ thể.
7. Thực hành vai trò BrSE — 現場で伝える
7.1. Tình huống giao tiếp
Vai trò: khách hàng phụ trách chất lượng phản hồi, BrSE chốt yêu cầu và Tech Lead phụ trách thí nghiệm. Mục tiêu: review pilot LoRA trong giới hạn GPU. Dữ kiện của tình huống tự soạn: bài thử linear đã xác minh phép toán và phản ví dụ đầu ra thay đổi; chưa có số đo GPU hoặc kết quả LLM. Chưa rõ: rank phù hợp, budget sequence length và mức hồi quy khách hàng chấp nhận.
- Khách hàng: LoRAなら、今のGPUで学習できるのでしょうか。既存の知識も残りますか。
Dùng LoRA thì có học được trên GPU hiện có không? Tri thức cũ có được giữ không? - BrSE: メモリの上限と、維持したい業務を分けて確認させてください。重みの固定と、回答品質の維持は別の確認事項です。
Xin xác nhận riêng giới hạn bộ nhớ và các nghiệp vụ cần duy trì. Đóng băng trọng số và duy trì chất lượng trả lời là hai điểm kiểm tra khác nhau. - Tech Lead: 学習するパラメーターは減らせますが、中間結果のメモリは必要です。入力長とバッチサイズを決めて測定します。
Có thể giảm tham số cần học, nhưng vẫn cần bộ nhớ cho kết quả trung gian. Chúng tôi chốt độ dài đầu vào và batch size rồi đo. - Khách hàng: メールの分類だけでなく、既存の日本語の回答品質も維持してください。
Xin giữ cả chất lượng trả lời tiếng Nhật hiện có, bên cạnh việc phân loại email. - BrSE: 承知しました。既存のテストケースも使い、劣化の許容範囲を先に合意したいです。
Đã rõ. Chúng tôi cũng dùng các ca kiểm thử cũ và muốn thống nhất trước mức suy giảm cho phép. - Khách hàng: ランクを大きくすれば、もっと安全に学習できますか。
Tăng rank thì có thể học an toàn hơn không? - Tech Lead: 必ずそうなるとは限りません。学習率とデータの品質も影響します。少数の候補を同じ条件で比較します。
Chưa chắc như vậy. Learning rate và chất lượng dữ liệu cũng ảnh hưởng. Chúng tôi so sánh một số ít cấu hình trong cùng điều kiện. - BrSE: 現時点では、小さな線形モデルで計算を確認した段階です。LLMの精度とGPUメモリは、まだ未検証です。
Hiện mới ở giai đoạn kiểm tra phép tính trên model tuyến tính nhỏ. Chất lượng LLM và bộ nhớ GPU vẫn chưa được kiểm chứng. - Khách hàng: では、測定前に条件を確認しましょう。基準を満たさない場合は、公開しないでください。
Vậy hãy xác nhận điều kiện trước khi đo. Nếu không đạt tiêu chí thì xin chưa phát hành. - BrSE: 私が本日中に受入条件案をまとめます。Tech Leadが次回レビューの前日までに測定計画を共有し、合意後に実験を開始します。
Tôi tổng hợp dự thảo điều kiện nghiệm thu trong hôm nay. Tech Lead chia sẻ kế hoạch đo chậm nhất ngày trước review tiếp theo, rồi bắt đầu thí nghiệm sau khi thống nhất.
7.2. Mẫu thông điệp dùng ngay
[レビュー日時] là mốc review người gửi cần điền theo lịch thực đã thống nhất. Mẫu chưa được gửi; không dùng thời điểm giả làm deadline của một dự án thật.
LoRAの検証方針を共有します。新しい業務の精度と、既存能力の維持を分けて評価します。GPUメモリの最大使用量は、学習ステップを通して測定します。現時点で確認済みなのは、線形モデルの計算のみです。BrSEが本日中に受入条件案をまとめ、Tech Leadが[レビュー日時]の前日までに測定計画を共有します。許容する劣化の範囲は、次回レビューで確認予定です。
Dịch: Xin chia sẻ hướng kiểm chứng LoRA. Chúng tôi đánh giá riêng độ chính xác của nghiệp vụ mới và việc duy trì năng lực cũ. Mức sử dụng bộ nhớ GPU cao nhất được đo qua training step. Hiện chỉ xác nhận phép tính của model tuyến tính. BrSE tổng hợp dự thảo điều kiện nghiệm thu trong hôm nay; Tech Lead chia sẻ kế hoạch đo chậm nhất ngày trước [thời điểm review]. Phạm vi suy giảm cho phép dự kiến được xác nhận ở review tiếp theo.
Ba cách diễn đạt đáng học: 分けて評価します tách các trục đánh giá; 確認済みなのは~のみです giới hạn rõ phạm vi bằng chứng đã có; 確認予定です nói kế hoạch xác nhận, không biến ngưỡng chưa chốt thành thỏa thuận.
7.3. Ghi chú dành cho BrSE
- Mỗi lời nói “giữ nguyên” cần một đối tượng cụ thể: W0, file base, tokenizer hay chất lượng khi bật adapter. Chốt đúng đối tượng mới chọn đúng phép kiểm.
- Đưa cấu hình workload vào mọi con số GPU: model/revision, precision, sequence length, micro-batch, accumulation, attention backend và phạm vi peak. “Vừa GPU” mà thiếu những điều này không đủ để bàn giao.
- Tách bằng chứng toán học, kiểm thử thư viện và kết quả LLM. Một ví dụ linear hội tụ hoặc adapter checkpoint nhỏ chưa chứng minh chất lượng Nhật–Việt hoặc hiệu năng production.
Nguồn tham khảo và phạm vi xác minh
Đọc ngày 17/10/2026; bài giải thích và ví dụ bằng lời riêng, không tái hiện benchmark nguồn:
- Edward J. Hu và cộng sự, LoRA, mục 4: cập nhật hạng thấp trên trọng số nền đóng băng. Không dùng tỷ lệ tiết kiệm của paper làm cam kết cho dự án.
- Hugging Face, LoRA trong PEFT v0.21.0: cấu hình, khởi tạo và target modules. Đã đọc tài liệu, chưa chạy API PEFT trong môi trường này.
- Microsoft, repository LoRA/loralib: implementation tham chiếu và vòng đời merge; khác API của PEFT.
- Hugging Face, GPU memory usage: các thành phần giữ bộ nhớ trong training.
- Tim Dettmers và cộng sự, QLoRA: base lượng tử hóa đóng băng và adapter trainable, cùng các kỹ thuật tiết kiệm trong nghiên cứu.
- Hugging Face, Quantization với PEFT: storage/compute dtype và chuẩn bị k-bit training.
- PyTorch, peak allocated và peak reserved: ý nghĩa các phép đo allocator. Dùng tài liệu API và mô tả được lập chỉ mục; trang trực tiếp trả chuyển hướng trong công cụ đọc của lượt này.
Xác minh ví dụ: ngày 17/10/2026, đã chạy code Python thuần mục 3.3 bằng Python 3.15.0 trong thư mục tạm, không cài dependency. Gradient check, khởi tạo, tối ưu, giữ W0, merge, phản ví dụ holdout, tắt adapter, bẫy khởi tạo 0 và năm ca đầu vào lỗi đều đạt assertion, kết thúc bằng all LoRA checks passed. Loss của mẫu tổng hợp giảm từ 0,225 xuống dưới 1e-10; holdout từ [0, 1] thành khoảng [0,403883; 0,798058] khi bật adapter. Đây là số đo của lớp linear nhỏ, không phải độ chính xác hoặc VRAM của LLM. Chưa chạy PEFT, QLoRA, GPU hay benchmark hồi quy LLM; phần đó là kế hoạch kiểm chứng.