Fine-tuning vs RAG vs In-Context Learning: Chiến lược lựa chọn cho doanh nghiệp
So sánh cơ chế, tổng chi phí, độ trễ, bảo mật và cách đo chất lượng của fine-tuning, RAG, ICL; thực hành bộ chấm Python và review phương án bằng tiếng Nhật.
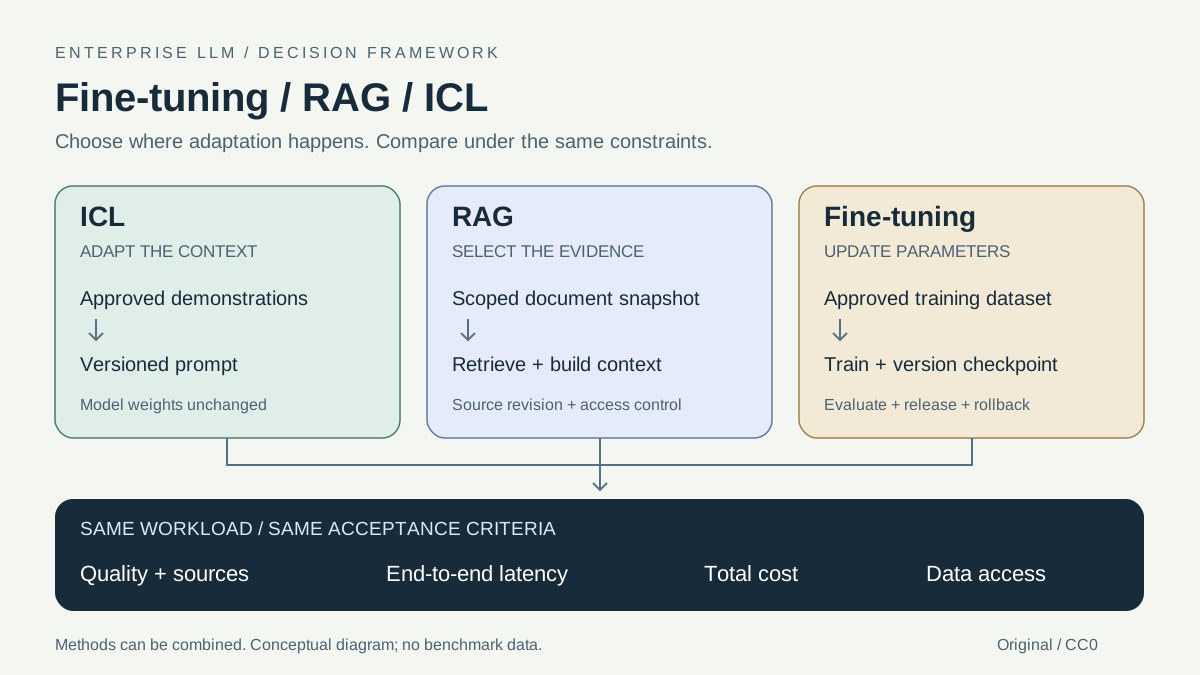
企業向けLLMの選択:追加学習・RAG・文脈内学習
Bối cảnh và giả định: một SaaS Việt–Nhật xây trợ lý trả lời câu hỏi vận hành thanh toán. Chính sách thay đổi theo phiên bản và tenant; đầu ra cần ngắn, đúng mẫu và có nguồn kiểm chứng. Nhóm đang chọn giữa dùng ví dụ trong prompt, truy xuất tài liệu và tinh chỉnh mô hình. Đây là tình huống tự soạn, không phải số liệu triển khai của một khách hàng.
Bài thuộc nhóm AI & Machine Learning, dành cho Senior Software Engineers, Tech Leads, DevOps/SRE, Solution Architects và BrSE. Cần biết Python, LLM inference và retrieval cơ bản. Phần Nhật hướng tới khoảng N3–N2. Mọi câu luyện đọc, hội thoại, code và fixture được biên soạn riêng, không phải bản dịch nguyên văn paper.
Ba kết quả sau bài học:
- Phân biệt nơi tri thức/hành vi được đưa vào hệ thống và cách kết hợp ba phương án.
- Lập phép so sánh có điều kiện về chi phí, latency, quyền dữ liệu và độ chính xác.
- Chạy bộ chấm replay tối thiểu và xác nhận phạm vi nghiệm thu bằng tiếng Nhật.
Key Takeaways: thiếu dữ liệu hiện hành khác với thiếu kỹ năng thực hiện nhiệm vụ; prompt ngắn không tự chứng minh tổng chi phí thấp; trả lời đúng nhưng dùng tài liệu sai tenant vẫn thất bại. Cần đo trên cùng bộ ca và cùng yêu cầu nguồn, đồng thời giữ các ca phải từ chối.
Bài Tối ưu hóa RAG đi sâu pipeline retrieval, còn Chunking và embedding phân tích đơn vị index. Bài này tập trung vào quyết định đầu tư vào context, retrieval hay training, không lặp lại cách triển khai vector search.
Hero là sơ đồ khái niệm SVG 1200×675 do BrSE.vn tự vẽ, phát hành theo CC0 1.0. Alt là tiêu đề bài. Các khối biểu diễn đường dữ liệu, không phải tỷ lệ hiệu quả đo được.
1. Đặt vấn đề và bối cảnh thực tế — なぜ必要なのか
Khách hàng hỏi: “Thanh toán đang pending có nên gửi lại không?”. Một câu trả lời đạt yêu cầu phải nhận biết trạng thái, dùng chính sách đúng phiên bản và không nhầm dữ liệu của tenant khác. Ngoài ra, khách hàng muốn văn phong Nhật lịch sự và định dạng đầu ra cố định. Đây là ba vấn đề khác nhau: kiến thức hiện hành, quyền truy cập, hành vi đầu ra.
Baseline nên bắt đầu với một prompt rõ, một vài ví dụ đã duyệt và context nhỏ có thẩm quyền. Nếu model làm đúng khi được cung cấp tài liệu nhưng sai khi không có tài liệu, cần điều tra đường cấp tri thức. Nếu đã có đúng tài liệu mà vẫn không phân loại đúng hoặc không tuân thủ mẫu qua nhiều ca, cần điều tra khả năng làm nhiệm vụ, prompt và dữ liệu huấn luyện. Không dùng một lần trả lời sai để kết luận phải fine-tune.
Đối với corpus thay đổi thường xuyên, sao chép mọi chính sách vào prompt gặp giới hạn context, chi phí truyền/lưu và nguy cơ chọn nhầm phiên bản. Huấn luyện lại sau mọi thay đổi cũng đòi tập dữ liệu, đánh giá và quy trình phát hành. RAG thêm một tầng tìm kiếm có thể lỗi, chậm hoặc bỏ sót nguồn. Mỗi phương án chuyển loại công việc vận hành sang một chỗ khác; không có phương án loại bỏ hoàn toàn việc bảo trì tri thức.
Tiêu chí đánh giá: chất lượng câu trả lời đúng nguồn, tỷ lệ trả lời khi thiếu căn cứ, độ phủ câu hỏi có thể giải quyết, lỗi vượt quyền, latency end-to-end p50/p95, throughput ở tải mục tiêu, tổng chi phí theo kỳ và khả năng rollback. Độ chính xác ở đây phải được định nghĩa trước, thay vì dùng một điểm “LLM quality” chung cho mọi yêu cầu.
Góc nhìn BrSE: “học dữ liệu công ty” có nghĩa là ghi nhớ tri thức, học giọng văn hay tìm tài liệu khi trả lời? Dữ liệu nào thay đổi mỗi ngày, dữ liệu nào ổn định? Có bắt buộc trích dẫn không? Được xử lý ở đâu, lưu bao lâu, ai được dùng checkpoint? Các ngưỡng chất lượng và thời gian phản hồi cần chốt cùng loại ticket, không tách khỏi điều kiện nghiệp vụ.
2. Bản chất kỹ thuật và cơ chế hoạt động — 仕組みを理解する
2.1. ICL: thay đầu vào, giữ nguyên tham số
Trong cách dùng In-Context Learning ở bài này, hướng dẫn và các cặp ví dụ được đưa vào context để mô hình thực hiện nhiệm vụ, không cập nhật trọng số trong lần suy luận. Brown và cộng sự, Language Models are Few-Shot Learners đánh giá thiết lập few-shot như vậy: nhiệm vụ và ví dụ được chỉ định bằng văn bản, không có gradient update ở giai đoạn áp dụng tác vụ.
Ví dụ tự soạn: prompt chứa hai cặp “ticket → mã xử lý”, một mẫu câu Nhật và đoạn chính sách cần dùng. Request mới được nối sau các ví dụ. Tài nguyên online gồm context, prefill, bộ nhớ phục vụ inference và số token đầu ra. Trọng số không đổi không có nghĩa dữ liệu sẽ không được log hoặc lưu ở dịch vụ; đó là một thuộc tính triển khai riêng phải xác minh.
Đưa thêm tài liệu vào context là cách cấp thông tin, nhưng ICL không đồng nghĩa với chép cả kho tài liệu vào prompt. Trong bảng so sánh, baseline ICL dùng ví dụ và context chọn sẵn; baseline RAG dùng bộ truy xuất để chọn context theo request. RAG cũng có thể dùng few-shot examples trong cùng prompt.
2.2. RAG: lấy bằng chứng ngoài rồi sinh câu trả lời
Lewis và cộng sự, Retrieval-Augmented Generation kết hợp bộ nhớ tham số của mô hình với bộ nhớ ngoài được truy xuất. Paper gốc có công thức và huấn luyện riêng; pipeline ứng dụng trong bài là thiết kế thực hành, không khẳng định mọi hệ RAG hiện nay giống implementation của paper.
Theo dấu request đề xuất: danh tính đã xác thực → xác định tenant và phiên bản → retrieval trong scope hợp lệ → chọn đoạn liên quan → lắp prompt → generator → kiểm tra đầu ra và nguồn. Khi index chưa cập nhật, quyền không rõ hoặc retrieval lỗi, trả trạng thái thiếu căn cứ/chuyển người phụ trách thay vì dùng trí nhớ của model để đoán chính sách hiện hành.
Tài nguyên offline gồm parser, embedding và index; tài nguyên online gồm query embedding nếu dùng, tìm kiếm, reranking nếu có và generation. Muốn thu hồi tài liệu phải xử lý cả index, cache và bản sao prompt/log liên quan theo chính sách hệ thống. Xóa một entry trong vector store chưa tự chứng minh mọi bản sao đã biến mất.
2.3. Fine-tuning: thay phân bố hành vi bằng cập nhật tham số
Theo hướng dẫn fine-tuning của Hugging Face, đây là tiếp tục huấn luyện một mô hình đã pretrained trên tập dữ liệu phục vụ nhiệm vụ/miền cụ thể. Với supervised fine-tuning sinh văn bản, cách diễn giải tối giản là tối ưu khả năng dự đoán đầu ra mong muốn từ đầu vào:
theta' = optimize(theta, training_examples)
loss   = - sum(log P_theta(target_token | input, previous_target_tokens))
theta là các tham số được huấn luyện, theta' là checkpoint sau cập nhật. Biểu thức giải thích mục tiêu dạng next-token; cách mask token, optimizer, full fine-tuning hay adapter phụ thuộc thiết lập. Bài không triển khai thuật toán LoRA; đó là chủ đề riêng của mục tiếp theo trong danh sách.
Một tập ticket được gán nhãn nhất quán có thể dạy cách phân loại, định dạng hoặc dùng thuật ngữ của dự án. Fine-tuning cũng có thể đưa kiến thức vào trọng số, nhưng việc cập nhật một sự thật, truy nguồn và thu hồi một tài liệu không còn là thay một dòng trong kho dữ liệu. Với dữ liệu hiện hành theo tenant, thiết kế bài này giữ nguồn có thẩm quyền bên ngoài model và kiểm tra quyền ở runtime, dù generator đã được fine-tune.
Luồng offline đề xuất: dữ liệu được phép dùng → làm sạch/gán nhãn → chia train/dev/test → training → đánh giá → checkpoint ứng viên → phê duyệt → phát hành. Online phải pin model/adapter revision. Khi chất lượng giảm, rollback về revision đã kiểm chứng; không âm thầm cập nhật checkpoint trong lúc so sánh vì sẽ làm kết quả không tái lập.
2.4. Ba lựa chọn có thể cùng nằm trong một request
OFFLINE
approved examples -> train/dev split -> training -> versioned checkpoint
approved documents -> parse/embed -> index snapshot + ACL + revision
approved demonstrations ------------> prompt version

ONLINE / one authenticated request
identity + question
        |
   tenant/version gate
        |
        +-> selected static context ----------+  ICL baseline
        |                                    |
        +-> scoped retrieval -> evidence -----+  RAG option
                                             v
                                   prompt + demonstrations
                                             |
                               base OR fine-tuned generator
                                             |
                               answer / citations / abstain
                                             |
                               policy + evidence validation
                                             |
                                       draft / blocked
Các nhánh biểu diễn cấu hình có thể chọn, không yêu cầu gọi hai generator trên mọi request. Phiên bản prompt, corpus/index và checkpoint phải đi cùng trace. Nếu thay đồng thời cả ba mà kết quả tăng, chưa biết thành phần nào tạo cải thiện.
Zhang và cộng sự, RAFT nghiên cứu fine-tuning cho bối cảnh trả lời với tài liệu truy xuất, gồm học bỏ qua tài liệu gây nhiễu. Đây là ví dụ nghiên cứu cho thấy training và retrieval có thể kết hợp; kết quả trên các tập trong paper không thay thế đánh giá corpus Việt–Nhật của dự án. Một phương án kết hợp chỉ được chọn khi lợi ích vượt chi phí thêm cho dữ liệu, serving và vận hành.
2.5. Chi phí và độ trễ: so cùng phạm vi
Mô hình chi phí dưới đây do bài đề xuất để lập bảng dự toán, không phải bảng giá nhà cung cấp:
TCO_s(N, H) = setup_s + refresh_s(H) + operations_s(H)
             + N * average_online_cost_s

online_cost = model_input + model_output + retrieval/rerank
              + allocated_serving + expected_retry_cost
s là phương án, N là số request trong cùng kỳ H. Setup bao gồm làm sạch/gán nhãn, huấn luyện hoặc tạo index; refresh bao gồm cập nhật và đánh giá lại; operations gồm giám sát, lưu trữ và nhân lực vận hành được phân bổ. Nếu dùng API, đừng cộng lại hạ tầng serving đã nằm trong giá API; nếu tự host, đừng bỏ qua GPU nhàn rỗi chỉ vì request ít.
Ví dụ tính hoàn toàn giả định: gom setup, refresh và operations cố định của RAG thành 600 đơn vị, FT thành 1500 đơn vị trong cùng kỳ. Chi phí online tương ứng 0,014 và 0,008 đơn vị/request. Điểm bằng nhau là (1500 − 600) / (0,014 − 0,008) = 150.000 request. Đây không phải USD hay giá cloud thật, và giả định cả hai đáp ứng cùng yêu cầu chất lượng/quyền. Nếu FT vẫn cần retrieval, phải tính lại chi phí kết hợp; không dùng số của FT-only để dự toán FT+RAG. Khi chi phí biên FT không thấp hơn, tăng lưu lượng không tự tạo điểm hòa vốn có lợi cho FT.
Tách latency thành xác thực/queue, retrieval nếu có, prefill, generation và validation. RAG thêm đường tìm kiếm, nhưng có thể giảm context so với nhét nhiều tài liệu vào prompt. Fine-tuning có thể giảm số ví dụ cần gửi nếu đã chứng minh giữ chất lượng; nó không tự làm phép forward của cùng kiến trúc nhanh hơn. Độ dài đầu ra, batching, cache hit, hardware và tải đồng thời đều cần cố định hoặc báo riêng.
Đo time to first token và thời gian hoàn tất riêng; người dùng có thể thấy token sớm trong khi request còn lâu mới xong. Đo p95 của toàn pipeline, không cộng p95 từng stage như một đẳng thức, vì các phân vị không có tính cộng như vậy. Số request thành công/giây chỉ có ý nghĩa cùng giới hạn lỗi và latency đã thống nhất.
2.6. Bảo mật: theo vết bản sao dữ liệu
Đánh giá theo nơi dữ liệu đi qua và tồn tại, không xếp hạng bảo mật chỉ bằng tên kỹ thuật:
| Đường dữ liệu | Bản sao cần kiểm soát trong thiết kế | Kiểm tra trước phát hành |
|---|---|---|
| ICL | Prompt mẫu, lịch sử hội thoại, cache, log request/response | Ví dụ đã khử dữ liệu nhạy cảm; isolation theo tenant; chính sách lưu/xóa |
| RAG | Nguồn gốc, index/embedding, cache retrieval, đoạn gửi generator, trace | ACL trước khi cấp context; cập nhật/thu hồi quyền; kiểm tra nguồn và revision |
| Fine-tuning | Dataset, bản export, checkpoint/adapter, registry, backup, môi trường train | Quyền dùng dữ liệu; kiểm tra rò rỉ; quyền tải model; quy trình tái huấn luyện/thu hồi |
Carlini và cộng sự cho thấy có thể trích xuất một số chuỗi huấn luyện từ mô hình trong thiết lập nghiên cứu của họ. Điều này là căn cứ để đánh giá nguy cơ ghi nhớ, không phải bằng chứng rằng mọi checkpoint fine-tune sẽ làm lộ cùng một loại dữ liệu hoặc cùng một tỷ lệ. Thiết kế bài này không dùng trọng số như ranh giới phân quyền giữa khách hàng.
Tự host có thể đáp ứng yêu cầu vị trí xử lý nhưng vẫn cần ACL, quản lý secret, log và backup. Dùng dịch vụ ngoài cần đọc điều kiện xử lý, lưu giữ, training và vùng dữ liệu của dịch vụ/tài khoản cụ thể tại thời điểm triển khai; bài không khẳng định chính sách của một nhà cung cấp. RAG cũng không tự ngăn prompt injection: nội dung tài liệu phải được xem là dữ liệu, không được cấp quyền thực thi chỉ vì được truy xuất.
2.7. Độ chính xác thực tế: thiết kế phép đo trước khi chọn
Tách ca kiểm thử theo các nhóm: biết đủ nguồn, thiếu nguồn, nguồn đổi phiên bản, sai tenant, dữ liệu mâu thuẫn, câu Nhật/Vietnamese paraphrase và yêu cầu ngoài phạm vi. Chia theo tài liệu/khách hàng/thời gian khi phù hợp, để các bản gần trùng của cùng ticket không rơi vào cả train lẫn test. Prompt demonstrations và dữ liệu training không được chứa nhãn/câu trả lời của bộ test giữ kín.
Đối với câu trả lời mở, dùng rubric có người rà về tính đúng, đủ điều kiện, đúng nguồn và không vượt quyền. Exact match chỉ phù hợp với đầu ra đã chuẩn hóa, như mã WAIT; không nên phạt hai cách diễn đạt Nhật tương đương chỉ vì khác chữ. Theo dõi coverage và độ đúng trên các câu đã trả lời cùng lúc, để model không đạt điểm đẹp bằng cách từ chối tất cả.
Lost in the Middle của Liu và cộng sự cho thấy vị trí thông tin trong context ảnh hưởng kết quả ở các tác vụ/mô hình được nghiên cứu. Vì thế, thử thay thứ tự nguồn và tài liệu nhiễu là một phép kiểm tra hữu ích; không suy rằng mọi model mới có cùng mức suy giảm. RAG cần đo cả tìm được nguồn lẫn sử dụng nguồn; fine-tuning cần đo cả nhiệm vụ mục tiêu lẫn ca hồi quy; ICL cần đo độ nhạy với ví dụ, thứ tự và context budget.
Khuyến nghị cho dự án giả định: đo prompt baseline trước; dùng retrieval cho tri thức có thẩm quyền thay đổi theo tenant; chỉ thử fine-tuning nếu có lỗi hành vi ổn định, dữ liệu huấn luyện phù hợp và phép đánh giá đủ tốt. Đây là quyết định theo ràng buộc, không phải một bảng xếp hạng độ chính xác của ba phương pháp.
最新の規程は、検索してモデルに渡します。回答形式は、まずプロンプトの例で指定します。追加学習が必要かどうかは、同じ評価条件で比較した上で判断します。根拠がない場合は、推測で回答せず、担当者に確認します。
Dịch: Chúng tôi tìm quy định mới nhất rồi đưa cho model. Trước hết, chúng tôi chỉ định định dạng trả lời bằng ví dụ trong prompt. Việc có cần fine-tuning hay không sẽ được quyết định sau khi so sánh trong cùng điều kiện đánh giá. Nếu không có căn cứ, chúng tôi không trả lời bằng suy đoán mà xác nhận với người phụ trách.
Phân tích câu: かどうか biến câu hỏi “có cần hay không” thành đối tượng của 判断します. 比較した上で đặt so sánh làm tiền đề cho quyết định. Chủ thể bị lược là nhóm dự án; câu cuối không nói model tự biết mọi lúc thiếu căn cứ, mà mô tả hành vi hệ thống phải được thiết kế và kiểm chứng.
3. Hiện thực hóa kỹ thuật — 実装する
3.1. Môi trường và cách chạy
Ví dụ là bộ chấm replay, dùng Python 3.11 trở lên và standard library. Nó đọc các câu trả lời đã ghi sẵn của ba cấu hình giả định; không huấn luyện, không retrieval thật và không gọi API model. Mục đích là kiểm tra hợp đồng đánh giá trước khi chi ngân sách chạy thí nghiệm thật.
Tạo thư mục thực hành với một file compare_strategies.py, chép trọn code mục 3.3 và chạy:
python3 --version
python3 compare_strategies.py
Mã xử lý: WAIT = chờ/kiểm tra trạng thái, SAME_KEY = chỉ retry theo quy tắc giữ cùng key, ESCALATE = chuyển người phụ trách; None là không đủ căn cứ để trả lời. Các mã chỉ là nhãn cho bài tập, không phải hướng dẫn thanh toán áp dụng chung.
3.2. Cách triển khai ban đầu
Một cách chấm đơn giản là đếm nhãn đúng:
def exact_accuracy(expected: list[str | None], actual: list[str | None]) -> float:
    if not expected or len(expected) != len(actual):
        raise ValueError("non-empty, aligned inputs required")
    return sum(a == b for a, b in zip(expected, actual)) / len(expected)
Đây là baseline hợp lý cho phân loại đã chuẩn hóa. Nhưng trong trợ lý có yêu cầu nguồn, câu SAME_KEY đúng từ ngữ vẫn không đạt nếu trích chính sách cũ. Một hệ chỉ trả lời hai câu dễ có thể đạt độ đúng cao trên hai câu đó nhưng bỏ hết ca khó. Bộ chấm cải tiến tách các mẫu số và giữ lỗi dữ liệu đo riêng với lỗi model.
3.3. Cách triển khai cải tiến
Mỗi Case có tenant, nhãn kỳ vọng và danh sách source ID/revision đã được người tạo bộ ca duyệt. Mỗi Prediction là một record cần có khi nối adapter thật. Mọi token count và elapsed time trong fixture dưới đây được tự đặt để thử phép tính, không phải số đo model. Source IDs gồm tenant và phiên bản; kiểm tra chuỗi trong code chỉ là bước kiểm tra provenance tối thiểu, chưa phải chứng minh ngữ nghĩa của tài liệu.
from __future__ import annotations

from dataclasses import dataclass, replace
from math import ceil, isfinite
from typing import Callable


@dataclass(frozen=True)
class Case:
    id: str
    tenant: str
    expected: str | None
    allowed_sources: frozenset[str]


@dataclass(frozen=True)
class Prediction:
    tenant: str
    answer: str | None
    citations: tuple[str, ...]
    input_tokens: int
    output_tokens: int
    elapsed_ms: float


def evaluate(cases: list[Case], predictions: dict[str, Prediction]) -> dict:
    ids = [c.id for c in cases]
    if not ids or len(set(ids)) != len(ids) or set(ids) != set(predictions):
        raise ValueError("empty, duplicate or unaligned cases")
    answered = exact = accepted = supported = correct_answers = 0
    latencies: list[float] = []
    tokens = 0
    for case in cases:
        p = predictions[case.id]
        if p.tenant != case.tenant:
            raise ValueError("tenant mismatch")
        if any(type(t) is not int or t < 0 for t in (p.input_tokens, p.output_tokens)):
            raise ValueError("invalid token usage")
        if not isfinite(p.elapsed_ms) or p.elapsed_ms < 0:
            raise ValueError("invalid latency")
        if p.answer is not None and (not isinstance(p.answer, str) or not p.answer):
            raise ValueError("invalid answer")
        if p.answer is None and p.citations:
            raise ValueError("abstention with citations")
        latencies.append(p.elapsed_ms)
        tokens += p.input_tokens + p.output_tokens
        matches = p.answer == case.expected
        exact += int(matches)
        if p.answer is None:
            accepted += int(case.expected is None)
            continue
        answered += 1
        correct_answers += int(matches)
        valid_source = bool(p.citations) and set(p.citations).issubset(case.allowed_sources)
        supported += int(valid_source)
        accepted += int(matches and valid_source)
    n = len(cases)
    return {
        "exact": exact / n,
        "accepted": accepted / n,
        "coverage": answered / n,
        "selective_accuracy": correct_answers / answered if answered else None,
        "citation_valid_rate": supported / answered if answered else None,
        "p95_ms_simulated": sorted(latencies)[ceil(0.95 * n) - 1],
        "tokens_simulated": tokens,
    }


CASES = [
    Case("pending", "A", "WAIT", frozenset({"A:policy-v2"})),
    Case("retry", "A", "SAME_KEY", frozenset({"A:retry-v3"})),
    Case("unknown", "A", None, frozenset()),
    Case("manual", "B", "ESCALATE", frozenset({"B:manual-v1"})),
]


def fixture(
    answers: list[str | None], refs: list[tuple[str, ...]],
    input_tokens: int, timings: list[float],
) -> dict[str, Prediction]:
    return {
        c.id: Prediction(c.tenant, answer, citations, input_tokens, 80, ms)
        for c, answer, citations, ms in zip(CASES, answers, refs, timings, strict=True)
    }


def expect_invalid(label: str, operation: Callable[[], object]) -> None:
    try:
        operation()
    except ValueError:
        print(label + ": rejected")
    else:
        raise AssertionError(label + " should fail")


def main() -> None:
    # Tất cả nhãn, nguồn, tokens và thời gian đều là fixture tự biên soạn.
    icl = fixture(
        ["WAIT", "NEW_KEY", None, "ESCALATE"],
        [("A:policy-v2",), ("A:retry-v1",), (), ("B:manual-v1",)],
        1600, [140, 160, 130, 180],
    )
    rag = fixture(
        ["WAIT", "SAME_KEY", "WAIT", None],
        [("A:policy-v2",), ("A:retry-v3",), ("A:policy-v2",), ()],
        700, [180, 210, 170, 190],
    )
    ft = fixture(
        ["RETRY", "SAME_KEY", None, "ESCALATE"],
        [(), ("A:retry-v1",), (), ("B:manual-v1",)],
        200, [90, 100, 80, 110],
    )
    for name, predictions, expected in (
        ("ICL_fixture", icl, 0.75), ("RAG_fixture", rag, 0.5),
        ("FT_fixture", ft, 0.5),
    ):
        report = evaluate(CASES, predictions)
        assert report["accepted"] == expected
        print(name, report)
    assert evaluate(CASES, ft)["exact"] == 0.75  # Đúng nhãn chưa đủ.
    assert evaluate(CASES, rag)["citation_valid_rate"] < 1
    abstain = {c.id: replace(icl[c.id], answer=None, citations=()) for c in CASES}
    assert evaluate(CASES, abstain)["selective_accuracy"] is None
    assert evaluate(CASES, abstain)["accepted"] == 0.25
    print("all_abstain: coverage=0; selective_accuracy=None")
    wrong_tenant = dict(icl)
    wrong_tenant["pending"] = replace(icl["pending"], tenant="B")
    negative_usage = dict(icl)
    negative_usage["pending"] = replace(icl["pending"], input_tokens=-1)
    invalid_time = dict(icl)
    invalid_time["pending"] = replace(icl["pending"], elapsed_ms=float("nan"))
    expect_invalid("wrong_tenant", lambda: evaluate(CASES, wrong_tenant))
    expect_invalid("negative_usage", lambda: evaluate(CASES, negative_usage))
    expect_invalid("invalid_time", lambda: evaluate(CASES, invalid_time))
    expect_invalid("missing_prediction", lambda: evaluate(CASES, {}))
    expect_invalid("empty_cases", lambda: evaluate([], {}))
    expect_invalid("duplicate_cases", lambda: evaluate(CASES + CASES[:1], icl))
    print("all replay checks passed")


if __name__ == "__main__":
    main()
evaluate() từ chối đầu vào không khớp case hoặc tenant thay vì âm thầm tính thành một câu trả lời sai. Đây là lỗi của hợp đồng dữ liệu thử nghiệm cần sửa trước khi báo điểm. Trong sản phẩm, ACL vẫn phải chặn trước retrieval/generation; bộ chấm offline không thể thu hồi dữ liệu đã gửi nhầm.
exact là tỷ lệ đúng nhãn trên toàn bộ case, kể cả None khi đó là kỳ vọng. accepted còn yêu cầu nguồn hợp lệ cho câu đã trả lời; từ chối đúng ở ca thiếu căn cứ vẫn được tính đạt. coverage đo tỷ lệ đã trả lời; selective_accuracy chỉ đo độ đúng nhãn trên các câu đã trả lời. Khi từ chối tất cả, chỉ số cuối là None, không gán thành 100%. citation_valid_rate kiểm tra source ID, chưa kiểm tra từng claim thực sự được nguồn hỗ trợ.
p95_ms_simulated dùng nearest-rank trên các thời gian fixture; với bốn điểm, kết quả là giá trị lớn nhất. Nó kiểm tra công thức, không tạo một p95 production đáng tin. tokens_simulated cũng chỉ cộng trường dữ liệu đã đặt, không tokenization, không phải usage thực nhận. Tên có hậu tố simulated để tránh trộn với log đo thật.
Trong phạm vi replay, không có concurrency, retry hay timeout mạng: không có request ngoài nào để điều phối. Khi nối hệ thật, ghi thời gian end-to-end bằng monotonic clock; lưu timeout/lỗi thành outcome riêng, đếm mọi lần retry vào usage và áp cùng giới hạn concurrency cho các cấu hình. Không bỏ các request lỗi khỏi thống kê latency/chất lượng một cách im lặng; báo cả tỷ lệ timeout và cách xử lý các quan sát bị cắt.
3.4. Cách kiểm chứng và mở rộng sang model thật
Thành công local là code in all replay checks passed, cả ba cấu hình fixture và các ca lỗi đều qua assertion. Các tỷ lệ kỳ vọng được suy ra từ chính fixture:
| Fixture tự đặt | Đúng nhãn (exact) |
Đạt cả nhãn/nguồn hoặc từ chối đúng (accepted) |
Điều được minh họa |
|---|---|---|---|
| ICL | 3/4 | 3/4 | Một lỗi nhãn và nguồn cũ |
| RAG | 2/4 | 2/4 | Có nguồn không liên quan không đủ; từ chối một ca vốn trả lời được |
| FT | 3/4 | 2/4 | Nhãn đúng nhưng nguồn sai phiên bản bị loại |
| Từ chối toàn bộ | 1/4 | 1/4 | Coverage bằng 0 không phải hệ giải quyết tốt bài toán |
Không dùng bảng này để kết luận ICL tốt hơn RAG hoặc FT. Tên phương án chỉ gắn cho các bản ghi tự đặt; không có model được chạy để tạo chúng. Bộ chấm hiện cũng chưa đọc nội dung source để kiểm chứng ngữ nghĩa, chưa tính uncertainty và chưa đánh giá văn phong Nhật. Kết quả thực thi code được ghi sau khi chạy tại cuối bài.
Để chạy pilot thực tế, thay fixture bằng record từ ba adapter cùng hợp đồng Prediction và giữ metadata bổ sung: model/adapter revision, prompt hash, corpus snapshot, generation config, request ID, cache status và provider usage. Baseline ICL dùng demonstrations cố định đã duyệt; baseline RAG dùng đúng corpus/scope được phép; FT dùng training split riêng và test giữ kín. Nếu so FT-only với RAG, ghi rõ phương án nào có tài liệu ở inference; thêm FT+RAG như một cấu hình riêng nếu cần.
Chạy lặp trên bộ test theo các nhóm nghiệp vụ, giữ output để người rà đánh giá mù tên phương án. Báo tỷ lệ cùng số lượng mẫu và khoảng bất định phù hợp; điều tra ca bất đồng trước khi lấy trung bình. Đo tải online ở cùng môi trường/tải, tách cache nóng/lạnh; thu chi phí thực theo kỳ đã chọn, kể cả các lần thử training thất bại hoặc bị loại. Chưa có dữ liệu ấy thì chỉ có kế hoạch đánh giá, chưa có kết luận độ chính xác hay ROI của doanh nghiệp.
4. Cạm bẫy thực tế và đánh đổi — 注意点とトレードオフ
4.1. Đưa chính sách thay đổi vào trọng số rồi quên vòng cập nhật
Triệu chứng: trả lời đúng văn phong nhưng dùng điều kiện thanh toán đã hết hiệu lực. Nguyên nhân: coi checkpoint là nguồn sự thật cập nhật tức thời. Phát hiện: bộ test theo thời gian, câu hỏi cùng tình huống nhưng khác phiên bản, rà căn cứ của từng câu. Khắc phục: cấp nguồn hiện hành theo scope lúc inference; dùng training cho hành vi ổn định nếu có bằng chứng ích lợi. Đánh đổi: có thêm đường retrieval và hai vòng đời model/index phải version; kết hợp hai phương án không miễn phí.
4.2. Dataset/test bị lẫn hoặc chỉ chọn câu dễ
Triệu chứng: điểm thử nghiệm cao nhưng ticket mới thất bại, nhất là tenant hoặc thời điểm chưa thấy. Nguyên nhân: bản sao gần giống nằm ở train và test; prompt chứa đáp án test; báo điểm chỉ trên ca đã trả lời. Phát hiện: so trùng theo nhóm tài liệu/khách hàng và rà sample nguồn gốc, đọc cả mẫu số. Khắc phục: holdout theo cách triển khai cần tổng quát hóa, giữ test kín, báo coverage và ca phải từ chối. Đánh đổi: giảm dữ liệu train và cần thêm gán nhãn; điểm mới có thể thấp hơn nhưng phản ánh đúng hơn phạm vi thử nghiệm.
4.3. RAG trả đúng nội dung nhưng sai quyền
Triệu chứng: một tenant nhìn thấy chính sách riêng của tenant khác hoặc nhận câu trả lời từ tài liệu đã bị thu hồi. Nguyên nhân: chỉ lọc kết quả sau generation, cache không có khóa quyền/phiên bản, hoặc worker dùng index snapshot cũ. Phát hiện: ca chéo tenant, đổi quyền trong lúc truy cập, cache hit sau thu hồi và trace nguồn. Khắc phục: xác thực/ACL trước cấp context, version quyền và nguồn trong cache key, kiểm tra cả embedding/index/log ở quy trình quản trị. Đánh đổi: thêm invalidation, giảm cache hit và tăng chi phí vận hành. Fine-tuning không phải cách thay thế ACL cho dữ liệu riêng từng khách hàng.
4.4. Chọn theo giá token hoặc latency mẫu đơn
Triệu chứng: prompt FT ngắn hơn nhưng hóa đơn cả kỳ tăng, hoặc demo trả nhanh nhưng p95 tải thật không đạt. Nguyên nhân: bỏ chi phí gán nhãn/training/refresh, đo cache nóng một request hoặc so đầu ra dài ngắn khác nhau. Phát hiện: đối chiếu usage, số request lỗi/retry và cost center; đo tải với phân bố đầu vào/đầu ra đã chốt. Khắc phục: cùng kỳ dự toán, cùng chất lượng và workload, ghi toàn pipeline, đánh giá cả phương án kết hợp. Đánh đổi: pilot cần thời gian và ngân sách; không phải mọi thí nghiệm đều dẫn tới một model được đưa vào vận hành.
| Phương án | Hiệu năng/độ trễ | Chi phí | Độ phức tạp | Độ tin cậy và vận hành | Khi nên chọn |
|---|---|---|---|---|---|
| ICL với context chọn sẵn | Ít stage, context dài có thể tăng prefill | Ít setup training; trả token/context mỗi request | Quản lý prompt, ví dụ và phiên bản | Dễ sửa prompt; cần đo độ nhạy với ví dụ và thứ tự | Nhiệm vụ mới, context nhỏ, ít dữ liệu gán nhãn |
| RAG | Thêm retrieval/rerank; context có thể gọn hơn baseline | Index/refresh/search và generation | Parser, index, ACL, cache và nguồn | Cập nhật nguồn độc lập model; lỗi retrieval vẫn lan xuống câu trả lời | Tri thức đổi thường xuyên, cần nguồn và quyền theo request |
| FT-only | Có thể giảm demonstrations; tốc độ phụ thuộc serving | Dataset, nhiều lần train/eval, serving, refresh | Model registry, dữ liệu và rollout | Học hành vi chuyên biệt; cập nhật/thu hồi tri thức khó hơn sửa nguồn | Hành vi/nhiệm vụ ổn định, có dữ liệu sạch và phép đo |
| FT + RAG + ví dụ chọn lọc | Vẫn có đường retrieval, cần đo end-to-end | Cộng cả vòng đời model và corpus | Cao hơn do nhiều artifact liên kết | Có thể cải thiện dùng nguồn/định dạng nếu được kiểm chứng | Baseline đã đo và lỗi còn lại cho thấy cần phối hợp |
So sánh trên là định tính, không phải benchmark. Với trợ lý thanh toán giả định, ưu tiên quyền và nguồn hiện hành trước; không đổi sang FT-only chỉ vì đạt chi phí biên thấp trong một bảng tính. Với phân loại ổn định trên dữ liệu ít đổi và không cần tra nguồn mới, một mô hình fine-tune hoặc thậm chí mô hình phân loại nhỏ cũng là ứng viên cần được đo.
5. Checklist trước khi triển khai — 本番環境への適用前チェック
- Chốt loại lỗi cần sửa: thiếu tri thức, chọn sai nguồn, sai hành vi hay sai quyền; có ca tái hiện cho từng nhóm.
- Train/dev/test và demonstrations không lẫn đáp án; test có ca theo thời gian, tenant, thiếu nguồn và ngoài phạm vi.
- Trace pin model, prompt và corpus/index revision; có dữ liệu để tái lập ca sai và rollback artifact tương ứng.
- ACL và cache đã qua ca chéo tenant/thu hồi quyền; dataset, checkpoint, prompt/log có người chịu trách nhiệm và quy trình lưu/xóa.
- Báo coverage, chất lượng có nguồn, tỷ lệ từ chối sai và timeout; không chỉ báo độ đúng trên câu đã trả lời.
- Đo end-to-end p50/p95, throughput và usage ở tải đã thống nhất; tách cache nóng/lạnh, đếm retry/lỗi.
- Dự toán cùng kỳ bao gồm setup, refresh, vận hành và online; khách hàng đã chốt ngưỡng nghiệm thu và cách chuyển người phụ trách.
6. Học tiếng Nhật qua chủ đề — 技術日本語を学ぶ
6.1. Sổ tay thuật ngữ kỹ thuật và giao tiếp BrSE
Hán Việt dùng để nhớ mặt chữ, không thay nghĩa chuyên môn. Câu ví dụ đều tự soạn trong bối cảnh chọn nguồn hiện hành, đo baseline trước training.
| Thuật ngữ Nhật | Furigana | Hán Việt | Nghĩa tiếng Việt / English | Câu ví dụ Nhật | Dịch nghĩa |
|---|---|---|---|---|---|
| 追加学習 | ついかがくしゅう | Truy gia học tập | Huấn luyện bổ sung; trong bài là fine-tuning | 追加学習の効果を検証します。 | Kiểm chứng hiệu quả của huấn luyện bổ sung. |
| 文脈内学習 | ぶんみゃくないがくしゅう | Văn mạch nội học tập | In-context learning | 文脈内学習では、プロンプトに例を含めます。 | Trong ICL, đưa ví dụ vào prompt. |
| 検索 | けんさく | Kiểm sách | Tìm kiếm / retrieval, search | テナントごとに検索範囲を制限します。 | Giới hạn phạm vi tìm kiếm theo tenant. |
| 根拠 | こんきょ | Căn cứ | Evidence, căn cứ | 根拠の版も確認します。 | Cũng kiểm tra phiên bản của nguồn căn cứ. |
| 評価 | ひょうか | Bình giá | Đánh giá / evaluation | 同じ条件で評価します。 | Đánh giá trong cùng điều kiện. |
| 精度 | せいど | Tinh độ | Độ chính xác; cần định nghĩa metric | 精度だけでなく、回答率も報告します。 | Báo cả tỷ lệ trả lời, bên cạnh độ chính xác. |
| 遅延 | ちえん | Trì diên | Độ trễ / latency | 検索を含めて遅延を測定します。 | Đo độ trễ bao gồm cả retrieval. |
| 機密情報 | きみつじょうほう | Cơ mật tình báo | Thông tin mật / confidential information | 機密情報を学習用データに含めません。 | Không đưa thông tin mật vào dữ liệu dùng để huấn luyện. |
| 権限 | けんげん | Quyền hạn | Quyền truy cập / permission | 検索前に権限を確認します。 | Kiểm tra quyền trước tìm kiếm. |
| 更新頻度 | こうしんひんど | Canh tân tần độ | Tần suất cập nhật / update frequency | 規程の更新頻度を確認します。 | Xác nhận tần suất cập nhật quy định. |
| 運用費用 | うんようひよう | Vận dụng phí dụng | Chi phí vận hành / operating cost | 運用費用も見積もりに含めます。 | Tính cả chi phí vận hành vào dự toán. |
| 受入条件 | うけいれじょうけん | - | Điều kiện nghiệm thu / acceptance criteria | 受入条件について合意します。 | Thống nhất về điều kiện nghiệm thu. |
Cặp dễ nhầm: 学習 có thể chỉ quá trình training hoặc learning theo ngữ cảnh, nên nói rõ có cập nhật tham số không; “đưa tài liệu vào prompt” chưa phải fine-tuning. 精度 trong trao đổi thường nói chung về chất lượng, trong báo cáo phải kèm metric và mẫu số. 要件 là điều cần đạt, 仕様 là cách hệ thống được quy định để thực hiện; yêu cầu “dùng đúng nguồn” cần cụ thể hóa thành phiên bản, ACL và điều kiện từ chối.
6.2. Ngữ pháp và mẫu diễn đạt
Các mẫu hướng tới giao tiếp khoảng N3–N2, không gán cấp JLPT chính thức.
| Mẫu | Ý nghĩa | Ví dụ |
|---|---|---|
| ~に応じて | Tùy theo điều kiện | 更新頻度に応じて方式を選びます。— Chọn phương thức theo tần suất cập nhật. |
| ~た上で | Sau khi hoàn thành bước tiền đề | 比較した上で判断します。— Quyết định sau khi so sánh. |
| ~とは限らない | Không nhất thiết | 追加学習だけで解決するとは限りません。— Chỉ fine-tuning chưa chắc giải quyết được. |
| ~かどうか | Có… hay không | 根拠が十分かどうかを確認します。— Kiểm tra xem căn cứ có đầy đủ không. |
1. ~に応じて
Cấu trúc: danh từ + に応じて + hành động, hoặc ~に応じた + danh từ. Chỉ sự điều chỉnh tương ứng với điều kiện, phù hợp trình bày thiết kế theo tần suất cập nhật hay tải. Mẫu không tự nói điều kiện ấy là nguyên nhân duy nhất.
- データの機密性に応じて、処理環境を選びます。— Chọn môi trường xử lý theo mức độ mật của dữ liệu.
- 利用量に応じて、費用の見積もりを見直します。— Điều chỉnh dự toán chi phí theo lượng sử dụng.
Lỗi dễ gặp: viết “tùy theo điều kiện” nhưng không định nghĩa điều kiện đo được. Trong đặc tả, thêm bảng mức tải/loại dữ liệu và hành vi tương ứng.
2. ~た上で
Cấu trúc: động từ thể た + 上で. Bước trước là tiền đề chủ ý cho bước sau; phù hợp review, quyết định phát hành và chốt phương án. Khác ~上に, vốn thêm một lý do/đặc điểm “hơn nữa”.
- 評価条件をそろえた上で、三つの方式を比較します。— So sánh ba phương thức sau khi thống nhất điều kiện đánh giá.
- 根拠を確認した上で、回答を提示します。— Đưa câu trả lời sau khi kiểm tra căn cứ.
Đừng dùng thể hiện tại 確認する上で để diễn đạt “sau khi xác nhận”; cấu trúc đó thường là “trong việc/khi xác nhận”. Hai cách tạo kỳ vọng thứ tự khác nhau.
3. ~とは限らない
Cấu trúc: mệnh đề thông thường + とは限らない. Phủ nhận tính tất yếu, không khẳng định kết quả ngược lại luôn đúng. Dùng khi khách hàng hỏi liệu fine-tuning luôn rẻ/nhanh/chính xác hơn hay không.
- プロンプトが短くても、総費用が下がるとは限りません。— Prompt ngắn hơn nhưng tổng chi phí chưa chắc giảm.
- 検索結果があっても、回答が正しいとは限りません。— Có kết quả truy xuất nhưng câu trả lời chưa chắc đúng.
Tránh dịch thành “không thể giảm/không thể đúng”. Khi đưa quan ngại, nối bằng kế hoạch đo để đối tác biết cách giải quyết sự chưa chắc chắn.
4. ~かどうか
Cấu trúc: mệnh đề nghi vấn có/không + かどうか + 確認する/調べる/判断する. Với danh từ/tính từ な, thường bỏ だ trước かどうか. Dùng khi xác nhận một điều kiện rõ ràng, không thay cho từ hỏi như “nguồn nào”.
- 追加学習が必要かどうかを判断します。— Quyết định có cần fine-tuning hay không.
- 旧版の資料が含まれていないかどうかを確認します。— Kiểm tra xem có lẫn tài liệu phiên bản cũ không.
Chú ý câu cuối có phủ định: việc cần kiểm tra là có lẫn bản cũ hay không, không phải đã xác nhận hoàn toàn không có bản cũ. Trong báo cáo, tách câu “sẽ kiểm tra” với “đã kiểm tra và kết quả là…”.
6.3. Luyện tập ngắn
- Điền mẫu thể hiện điều chỉnh theo điều kiện: 更新頻度( )、検索の構成を見直します。
- Dịch Việt → Nhật: “Chúng tôi quyết định có cần fine-tuning hay không sau khi so sánh trong cùng điều kiện.”
- Sửa câu quá khẳng định và thêm kế hoạch kiểm chứng: 追加学習をすれば、必ず費用が下がります。— “Cứ fine-tune là chắc chắn giảm chi phí.”
Đáp án và giải thích:
に応じて: 更新頻度に応じて、検索の構成を見直します。— Điều chỉnh cấu hình tìm kiếm theo tần suất cập nhật. Mẫu nối điều kiện với hành vi thiết kế.- 同じ条件で比較した上で、追加学習が必要かどうかを判断します。— Quyết định có cần fine-tuning hay không sau khi so sánh trong cùng điều kiện. Thứ tự là so sánh rồi quyết định.
- 追加学習をしても、総費用が下がるとは限りません。更新と運用の費用も含めて比較します。— Dù fine-tune, tổng chi phí chưa chắc giảm. Chúng tôi so sánh cả chi phí cập nhật và vận hành. Câu sửa nêu đúng phạm vi TCO thay vì chỉ giá inference.
7. Thực hành vai trò BrSE — 現場で伝える
7.1. Tình huống giao tiếp
Vai trò: khách hàng quản lý vận hành, BrSE làm rõ yêu cầu, Tech Lead phụ trách pilot. Mục tiêu là chọn phạm vi thử nghiệm, chưa phê duyệt training hay production. Dữ kiện của tình huống tự soạn: chính sách thay đổi theo phiên bản, bản đầu cần trích nguồn, bộ chấm replay đã kiểm tra logic. Chưa rõ: chất lượng model thật, p95 và chi phí tổng trong kỳ.
- Khách hàng: 社内資料を学習させれば、最新の規程にも回答できますか。
Nếu cho học tài liệu nội bộ thì có thể trả lời cả quy định mới nhất không? - BrSE: 今回の「学習」は、資料を検索して渡すことも含むという理解でよろしいでしょうか。
Tôi hiểu từ “học” lần này cũng bao gồm tìm tài liệu rồi đưa cho model, như vậy có đúng không? - Khách hàng: はい。重視するのは、現在の規程に基づくことと、根拠を示すことです。
Đúng. Điều chúng tôi coi trọng là dựa trên quy định hiện tại và chỉ ra căn cứ. - Tech Lead: その要件には、まず権限を確認した資料を検索する構成を試します。回答形式はプロンプトの例で指定します。
Với yêu cầu đó, trước hết chúng tôi thử kiến trúc truy xuất tài liệu đã kiểm tra quyền. Định dạng trả lời được chỉ định bằng ví dụ trong prompt. - Khách hàng: 追加学習のほうが速くて安いのではないでしょうか。
Liệu fine-tuning có nhanh và rẻ hơn không? - BrSE: 必ずそうなるとは限りません。学習用データの作成と更新も含めて、同じ期間で比較する必要があります。
Chưa chắc như vậy. Cần so sánh trong cùng kỳ, tính cả việc tạo và cập nhật dữ liệu huấn luyện. - Tech Lead: ローカルで評価処理は確認しましたが、実モデルの精度と遅延はまだ測定していません。同じテストケースで測定します。
Chúng tôi đã kiểm tra logic đánh giá ở local, nhưng chưa đo chất lượng và độ trễ của model thật. Chúng tôi sẽ đo bằng cùng bộ ca. - Khách hàng: 別のテナントの資料は使わないでください。根拠がない場合は、回答せずに担当者へ確認してください。
Xin không dùng tài liệu của tenant khác. Nếu không có căn cứ, đừng trả lời mà hãy xác nhận với người phụ trách. - BrSE: 承知しました。私が本日中に受入条件案をまとめます。次回レビューで、費用と応答時間の上限を確認させてください。
Đã rõ. Tôi sẽ tổng hợp dự thảo điều kiện nghiệm thu trong hôm nay. Xin xác nhận giới hạn chi phí và thời gian phản hồi ở buổi review tiếp theo. - Tech Lead: 私がテストケースと測定計画を準備します。レビューの前日までに共有し、条件の合意後に実験を開始します。
Tôi chuẩn bị bộ ca và kế hoạch đo, chia sẻ chậm nhất ngày trước buổi review, rồi bắt đầu thí nghiệm sau khi thống nhất điều kiện.
7.2. Mẫu thông điệp dùng ngay
[レビュー日時] là thời điểm review người gửi cần điền theo lịch đã thống nhất. Các mốc tương đối phụ thuộc thời điểm đó; đây là mẫu luyện viết, chưa phải tin nhắn đã gửi.
本日の確認事項を共有します。初期の比較では、プロンプトの例と権限を確認した検索結果を利用します。根拠がない場合は、担当者に確認します。追加学習の採否は、評価後に判断します。BrSEが本日中に受入条件案をまとめ、Tech Leadが[レビュー日時]の前日までに測定計画を共有します。費用と応答時間の上限は、次回レビューで確認予定です。
Dịch: Xin chia sẻ các điểm xác nhận hôm nay. Trong so sánh ban đầu, chúng tôi dùng ví dụ trong prompt và kết quả tìm kiếm đã kiểm tra quyền. Nếu không có căn cứ, chúng tôi xác nhận với người phụ trách. Quyết định có áp dụng fine-tuning hay không được đưa ra sau đánh giá. BrSE tổng hợp dự thảo điều kiện nghiệm thu trong hôm nay; Tech Lead chia sẻ kế hoạch đo chậm nhất ngày trước [thời điểm review]. Giới hạn chi phí và thời gian phản hồi dự kiến được xác nhận ở review tiếp theo.
Ba cách diễn đạt: 採否 nói rõ quyết định áp dụng hay không áp dụng; 評価後に判断します đặt quyết định sau bằng chứng đánh giá; 確認予定です ghi kế hoạch xác nhận, không nói đã có thỏa thuận về ngưỡng.
7.3. Ghi chú dành cho BrSE
- Khi khách hàng nói “cho AI học”, ghi rõ nơi dữ liệu xuất hiện: prompt, index hay trọng số; mỗi nơi có vòng cập nhật, truy nguồn và quản trị khác nhau.
- Khi báo “chính xác 90%”, luôn kèm mẫu số, nhóm ca, coverage, cách chấm và yêu cầu nguồn. Không chuyển điểm fixture, điểm training hay điểm một paper thành cam kết chất lượng dự án.
- Khi trình chi phí hoặc thời gian, giữ cùng kỳ, workload, chất lượng và ranh giới xử lý dữ liệu. Một thay đổi prompt/model/corpus phải được phản ánh trong kế hoạch đo và tài liệu bàn giao.
Nguồn tham khảo và phạm vi xác minh
Đọc ngày 17/10/2026. Liên kết paper dùng phần abstract cho các luận điểm được nêu; không tái hiện benchmark hoặc dịch nguyên văn paper:
- Tom B. Brown và cộng sự, Language Models are Few-Shot Learners: few-shot bằng context mà không gradient update lúc áp dụng tác vụ.
- Patrick Lewis và cộng sự, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks: kết hợp bộ nhớ tham số và bộ nhớ truy xuất ngoài.
- Hugging Face, Fine-tuning trong Transformers: nguyên lý tiếp tục huấn luyện mô hình pretrained. Bài không gọi API thư viện này nên không xác nhận tương thích một phiên bản SDK cụ thể.
- Tianjun Zhang và cộng sự, RAFT: Adapting Language Model to Domain Specific RAG: ví dụ kết hợp fine-tuning và tài liệu truy xuất trong nghiên cứu.
- Nelson F. Liu và cộng sự, Lost in the Middle: ảnh hưởng vị trí thông tin trong context ở thiết lập được nghiên cứu.
- Nicholas Carlini và cộng sự, Extracting Training Data from Large Language Models: nguy cơ trích xuất dữ liệu huấn luyện trong thiết lập nghiên cứu cụ thể.
Xác minh ví dụ: ngày 17/10/2026, đã chạy nguyên code mục 3.3 bằng Python 3.15.0 trong thư mục tạm, không cài dependency. Ba bộ replay, ca từ chối toàn bộ và sáu ca đầu vào lỗi đạt assertion, kết thúc bằng all replay checks passed. Điểm accepted của fixture ICL/RAG/FT lần lượt là 0,75/0,5/0,5, đúng với bảng tự đặt ở mục 3.4; đây không phải độ chính xác của các mô hình thật. Chưa fine-tune hoặc gọi LLM thật, chưa đo chất lượng, token, latency hay chi phí dịch vụ thực tế. Công thức TCO, kiến trúc đề xuất, fixture và hội thoại là phần tự biên soạn.