Tối ưu hóa RAG: Từ Naive RAG đến Advanced và Modular RAG
Thiết kế pipeline RAG có pre-retrieval, reranking và ngân sách context; thực hành Python, đo chất lượng theo từng tầng và trao đổi phương án bằng tiếng Nhật.
RAGの最適化:Naive RAGからAdvanced RAG、Modular RAGへ
Bối cảnh giả định: một SaaS có tài liệu vận hành bằng tiếng Anh và tiếng Nhật, tách dữ liệu theo tenant. Đội Việt–Nhật xây trợ lý giải đáp sự cố thanh toán. Người dùng cần câu trả lời đúng phiên bản, có căn cứ và không lộ tài liệu của khách hàng khác. Đây là thiết kế minh họa tự biên soạn, không phải báo cáo một hệ thống đang vận hành.
Bài thuộc nhóm AI & Machine Learning, dành cho Senior Engineers, Tech Leads, DevOps/SRE, Solution Architects và BrSE. Kiến thức nền: Python, embedding, HTTP timeout và phân quyền ứng dụng. Phần Nhật phù hợp khoảng N3–N2; các câu Nhật đều tự soạn, không phải trích dẫn từ paper.
Sau bài này, người đọc có thể:
- Chẩn đoán lỗi nằm ở truy xuất ứng viên, xếp hạng hay đóng gói context thay vì chỉ đổi LLM.
- Chạy một controller Python có lọc metadata, viết lại truy vấn, reranking thay thế được và giới hạn context rõ ràng.
- Giải thích đánh đổi chất lượng–độ trễ, xác nhận phạm vi nghiệm thu và báo cáo giới hạn bằng tiếng Nhật.
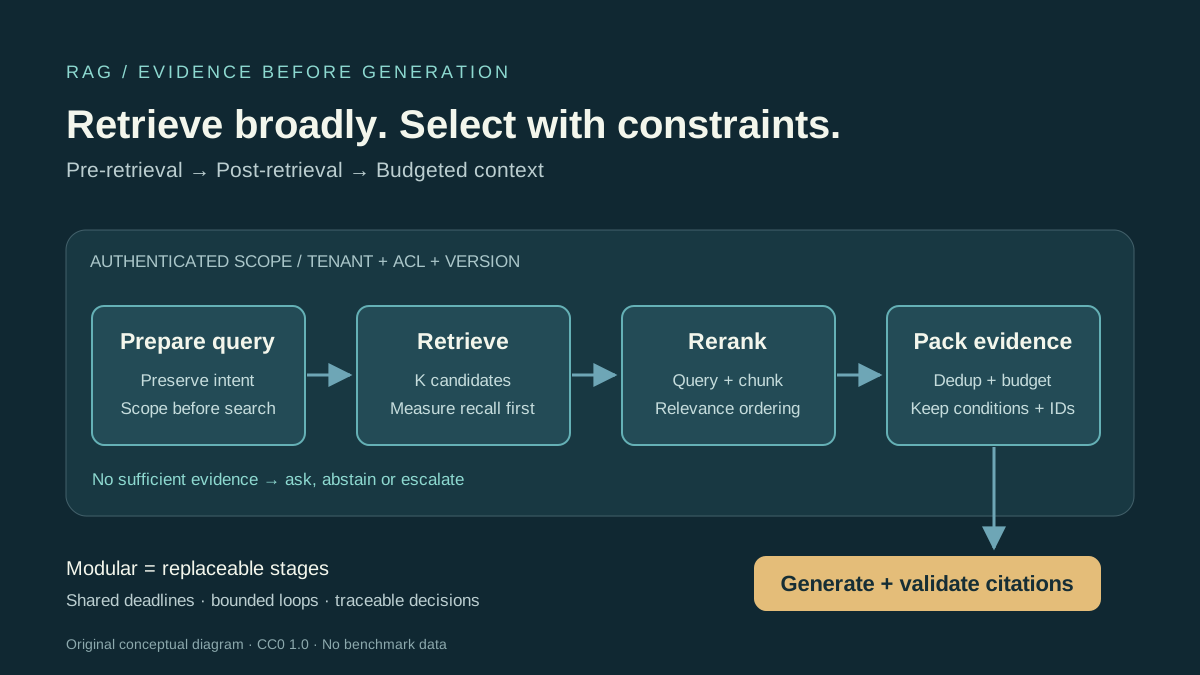
Ảnh hero là sơ đồ khái niệm SVG tự vẽ cho bài này, phát hành theo CC0 1.0. Sơ đồ không biểu diễn benchmark hay dữ liệu production; mô tả thay thế của ảnh là tiêu đề bài.
1. Đặt vấn đề và bối cảnh thực tế — なぜ必要なのか
Người dùng hỏi: “Checkout timeout thì có retry được không?”. Kho tri thức có trang hướng dẫn chung về timeout, bản hướng dẫn thanh toán cũ và quy trình hiện hành yêu cầu giữ nguyên idempotency key. Một hệ thống lấy ba đoạn gần query nhất có thể trả về nhiều đoạn lặp về timeout nhưng thiếu điều kiện chống thanh toán hai lần. LLM vẫn có thể viết một câu rất trôi chảy.
Naive RAG thường được mô tả bằng chuỗi index → retrieve → generate. Advanced RAG thêm tối ưu trước và sau truy xuất; Modular RAG cho phép ghép, định tuyến và điều khiển các thành phần linh hoạt hơn. Đây là cách phân loại trong khảo sát của Gao và cộng sự, mục II, không phải ba cấp chứng nhận chất lượng hay yêu cầu phải nâng cấp tuần tự.
Cũng cần phân biệt cách gọi RAG trong ứng dụng hiện nay với paper RAG gốc của Lewis và cộng sự: nghiên cứu đó kết hợp bộ nhớ tham số với dense index và huấn luyện mô hình, có hai biến thể lựa chọn bằng chứng theo sequence hoặc token. Ví dụ trong bài này chỉ xây luồng điều phối ở thời điểm suy luận, không tái hiện quá trình huấn luyện ấy.
Để chọn giải pháp, tách ba câu hỏi nghiệm thu:
- Có tìm thấy bằng chứng không? Recall@K của candidate set, phân tách theo ngôn ngữ, phiên bản và loại câu hỏi.
- Có đưa bằng chứng vào prompt không? Tỷ lệ giữ đoạn bắt buộc sau reranking và packing; lượng context bị loại.
- Có trả lời đúng và đúng quyền không? Đánh giá câu trả lời, độ hỗ trợ của trích dẫn, hành vi thiếu bằng chứng và kiểm thử cách ly tenant.
Latency cần đo p50/p95 cùng concurrency cố định; throughput là số request hoàn thành trên đơn vị thời gian ở tải đó. Chi phí gồm indexing, embedding truy vấn, reranker, input/output của generator và vận hành. Chưa có dữ liệu tải thì chưa thể khẳng định reranking “rẻ hơn” chỉ vì prompt ngắn hơn.
Góc nhìn BrSE: khách hàng muốn giảm thời gian xử lý sự cố, nhưng “trả lời chính xác” còn mơ hồ. Cần chốt tài liệu nào có thẩm quyền, câu hỏi về bản cũ có được hỗ trợ không, thiếu tài liệu thì hỏi lại hay chuyển nhân viên, và ngân sách độ trễ có bao gồm truy xuất hay chỉ sinh câu trả lời. Trong tình huống này, câu “có thể retry” chỉ được chấp nhận nếu giữ đủ điều kiện về idempotency và trạng thái giao dịch.
2. Bản chất kỹ thuật và cơ chế hoạt động — 仕組みを理解する
2.1. Tách luồng offline và online
OFFLINE: sources -> parse + version + ACL -> chunks -> index snapshot
                                                       |
ONLINE: authenticated principal + original question     |
            |                                          |
       scope + query preparation                       |
            |                                          v
       retrieve candidates <----------------------- scoped index
            |
       pair rerank -> deduplicate -> budgeted context
            |                               |
       no evidence                       evidence
            |                               |
       ask / abstain            generator -> citation validation
                                            |
                                       answer / escalate
Index là trạng thái dùng chung, có vòng đời riêng. Một request nên ghi lại index_snapshot, phiên bản query rewriter/reranker và danh sách chunk ID được chọn để có thể điều tra. Quyền truy cập phải lấy từ principal đã xác thực, không lấy từ câu hỏi hoặc nội dung do LLM sinh. Nếu hệ thống hỗ trợ nhiều nhóm quyền trong cùng tenant, chỉ kiểm tra tenant là chưa đủ.
Trong thiết kế này, request được giữ trên cùng một snapshot logic. Khi ACL thay đổi, cần cơ chế thu hồi hoặc kiểm tra lại quyền trước khi phát hành câu trả lời; chỉ pin snapshot không bảo đảm dữ liệu còn được phép đọc. Đây là quyết định ứng dụng, cần thống nhất với bộ phận quản lý dữ liệu.
2.2. Pre-retrieval: sửa đầu vào trước khi tăng K
Chuẩn bị index: giữ tiêu đề, section, sản phẩm, phiên bản, trạng thái tài liệu và ACL cùng chunk. Chia theo ranh giới nội dung giúp giữ điều kiện và kết luận cùng nhau; bảng có tiêu đề cột và chú thích phải còn đọc được sau trích xuất. Không đi sâu thuật toán semantic chunking ở đây: trọng tâm là tạo đầu vào có đủ metadata để pipeline chọn đúng bằng chứng.
Chuẩn bị query: phân giải câu nối tiếp theo hội thoại đã được phép dùng, bảo toàn mã lỗi, tên API, phủ định và phiên bản. Ma và cộng sự nghiên cứu Rewrite–Retrieve–Read để xử lý khoảng cách giữa câu hỏi người dùng với tri thức cần tìm. Trong ví dụ tự soạn, “checkout timeout” được bổ sung “retry idempotency”. Query gốc vẫn được lưu để đối chiếu; rewrite không được tự thêm kết luận “retry luôn an toàn”.
Một lựa chọn khác là HyDE: sinh một tài liệu giả định, embed nó rồi tìm tài liệu thật lân cận. Văn bản giả định có thể chứa chi tiết sai; nó là phương tiện truy xuất, không được biến thành nguồn trích dẫn. Với mã lỗi chính xác hoặc tên sản phẩm hiếm, thử nhánh lexical giữ nguyên chuỗi trước khi dùng mở rộng sinh bởi LLM.
Nếu chạy nhiều query, hợp nhất theo ID ổn định rồi mới rerank. Ngân sách K cần tính cho tập hợp chung; không để mỗi nhánh tự lấy K rồi vô tình nhân số cặp reranker lên theo số nhánh. Phần demo dùng một query mở rộng xác định để người đọc quan sát được luồng mà không cần model.
2.3. Post-retrieval: reranking không thể tạo lại bằng chứng đã bỏ sót
Bi-encoder tính biểu diễn query và document riêng, thích hợp để tìm ứng viên trên index lớn. Cross-encoder đọc cùng cặp query–document để chấm mức liên quan; vì phải chạy trên từng cặp, nên thường dùng ở tầng sau trên tập ứng viên nhỏ. Đây là cơ chế được minh họa trong Sentence Transformers: Retrieve & Re-Rank.
Tách K ứng viên và m đoạn cuối. Ví dụ thiết kế thử nghiệm có thể lấy K=40, rerank rồi đóng gói tối đa m=6; đây là cấu hình để thử, không phải giá trị tối ưu. Nếu đoạn về idempotency không nằm trong 40 ứng viên, reranker không cứu được. Đánh giá candidate recall trước khi quy lỗi cho model xếp hạng.
Điểm reranker phụ thuộc model, activation và dữ liệu; không coi score bất kỳ là xác suất đúng của câu trả lời. Ngưỡng abstain phải hiệu chỉnh trên dữ liệu gán nhãn của bài toán và kiểm tra lại khi đổi model. Demo dưới đây dùng điểm quy tắc, không sử dụng ngưỡng model thật.
2.4. Context là một bài toán chọn bằng chứng có ràng buộc
Ngân sách dành cho bằng chứng cần thỏa:
B_evidence <= W_model - T_instructions - T_question
                      - T_history - T_output_reserved - T_margin
Tất cả biến ở công thức là token theo tokenizer và cách serialize của generator. W_model là giới hạn model thực tế được cấu hình; T_output_reserved dành cho phần sinh. Phải tính cả nhãn nguồn, ID, JSON/tool wrapper nếu có. Không dùng số ký tự chia một hằng số để hứa chắc request sẽ vừa giới hạn.
Đề xuất của bài là đóng gói theo thứ tự liên quan, loại bản sao và giữ nguyên chunk đủ ngắn; ghi lại đoạn bị loại vì ngân sách. Với câu hỏi cần nhiều bằng chứng, nên xem mỗi điều kiện nghiệp vụ là một yêu cầu bao phủ: đoạn đứng đầu có thể chưa chứa cả quy trình kiểm tra trạng thái lẫn quy tắc retry. Nén trích xuất giữ nguyên câu nguồn dễ kiểm toán hơn tóm tắt sinh, nhưng có thể vẫn mất ngữ cảnh nếu cắt bỏ câu phủ định hay tiêu đề bảng.
Lost in the Middle cho thấy vị trí thông tin ảnh hưởng chất lượng trong các tác vụ và model được thử của nghiên cứu. Không suy từ đó rằng mọi model hiện tại đều có cùng đường cong suy giảm. Với hệ thống đang xây, thử hoán đổi vị trí cùng một bộ bằng chứng để đo độ nhạy; giữ đoạn cần thiết rõ ràng và loại nhiễu trước khi tăng context window.
2.5. Modular RAG: module có hợp đồng và điểm dừng
Modular RAG của Gao và cộng sự mô tả các cơ chế routing, scheduling, fusion cùng các mẫu tuyến tính, điều kiện, phân nhánh và vòng lặp. Modular không đồng nghĩa nhiều agent hoặc bắt buộc truy xuất nhiều lần.
Trong kiến trúc đề xuất ở đây, router chọn kho runbook cho câu hỏi sự cố, kho API cho câu hỏi tham số. Mỗi retriever trả cùng cấu trúc (chunk_id, version, scope, text, score); reranker trả thứ tự trên các ID đã được cấp quyền. Controller có deadline chung, tối đa số vòng và giới hạn context. Nhờ đó có thể thay model reranking mà giữ nguyên kiểm tra ACL, log và cách đóng gói.
Điểm chờ thường là I/O tới index, hàng đợi reranker và generator. Khi hết deadline, dừng nhánh còn lại thay vì tiếp tục tiêu tài nguyên sau khi client đã bỏ cuộc. Nếu reranker lỗi, chỉ fallback sang thứ tự retrieval nếu nhánh đó đã có tiêu chí chất lượng được duyệt; nếu không, trả trạng thái chưa đủ bằng chứng. Retry có giới hạn cho lỗi tạm thời, không retry vô hạn lỗi xác thực, schema hay input quá dài. Mọi vòng truy xuất mới đều phải áp lại cùng scope quyền.
まず、利用者の権限に基づいて検索対象を限定します。次に、候補を取得した上で、質問との関連性を再評価します。入力の上限に応じて、根拠となる文書を選択します。ただし、根拠が不足している場合は、回答を保留します。
Dịch: Trước hết, giới hạn phạm vi tìm kiếm dựa trên quyền người dùng. Tiếp theo, sau khi lấy các ứng viên, đánh giá lại mức liên quan với câu hỏi. Chọn tài liệu làm căn cứ tùy theo giới hạn đầu vào. Tuy nhiên, nếu thiếu căn cứ thì tạm hoãn trả lời.
Trong câu thứ hai, chủ thể lược là hệ thống; ~た上で nhấn mạnh thứ tự có điều kiện hoàn tất. ただし ở câu cuối giới hạn việc trả lời, không phủ định toàn bộ bước tìm kiếm.
3. Hiện thực hóa kỹ thuật — 実装する
3.1. Môi trường và cách chạy
Ví dụ gồm một file rag_demo.py, dùng Python 3.11+ và thư viện chuẩn, không cài package, tải model hay gọi mạng. Đã chạy bằng Python 3.15.0 trong lần biên soạn. Nội dung corpus tiếng Anh được tự soạn để quy tắc tách từ dễ kiểm tra; không dùng kết quả này để đánh giá truy xuất tiếng Nhật.
Lưu toàn bộ khối Python ở mục 3.3 vào file rồi chạy:
python3 rag_demo.pyPhạm vi chạy là retrieval → reranking quy tắc → context selection. Không có vector DB, cross-encoder thật hay generator. Mục tiêu là kiểm tra hợp đồng module, cách ly tenant, nguồn hiện hành, chống trùng và giới hạn đầu vào trước khi nối các dịch vụ tốn tài nguyên.
3.2. Cách triển khai ban đầu
Baseline dùng lexical overlap, giữ scope tenant và nối hai đoạn đầu. Cách này hợp lý khi kho nhỏ, từ ngữ truy vấn khớp tài liệu và các tài liệu đều còn hiệu lực. Nó chưa phân biệt runbook hiện hành và bản cũ; hai bản sao có thể chiếm hết context. Hàm naive() ở ví dụ hoàn chỉnh thể hiện đúng hạn chế đó. Không được bỏ phân quyền để tạo baseline: chất lượng thấp là một vấn đề khác với rò rỉ dữ liệu.
3.3. Cách triển khai cải tiến
PairScorer là điểm thay module reranking. Bản demo truyền rule_pair_score, một hàm lexical có trọng số cho từ idempotency; đây là quy tắc nghiệp vụ minh họa đã biết trước, không phải cross-encoder, không phải semantic search. Khi nối model thật, adapter cần chấm cùng cặp query–chunk, kiểm tra truncation và trả score hữu hạn. Không tái sử dụng trọng số quy tắc như một kết quả học được.
from collections.abc import Callable
from dataclasses import dataclass
import math
import re


@dataclass(frozen=True)
class Chunk:
    id: str
    tenant: str
    version: str
    current: bool
    text: str


CORPUS = (
    Chunk("old", "A", "v1", False,
          "Checkout timeout retry: use the legacy payment procedure."),
    Chunk("generic", "A", "v2", True,
          "Checkout timeout: inspect network latency and logs."),
    Chunk("duplicate", "A", "v2", True,
          "Checkout timeout: inspect network latency and logs."),
    Chunk("safe", "A", "v2", True,
          "Payment retry after timeout: keep the same idempotency key. "
          "Check transaction status before retrying checkout."),
    Chunk("secret", "B", "v2", True,
          "Checkout timeout retry idempotency: confidential tenant B data."),
)
PairScorer = Callable[[str, Chunk], float]


def terms(text: str) -> set[str]:
    return set(re.findall(r"[a-z0-9]+", text.lower()))


def retrieve(query: str, docs: tuple[Chunk, ...], k: int) -> list[Chunk]:
    scored = [(len(terms(query) & terms(d.text)), d) for d in docs]
    # Stable tie-break by ID; exclude zero-overlap candidates.
    scored.sort(key=lambda pair: (-pair[0], pair[1].id))
    return [d for score, d in scored if score > 0][:k]


def naive(query: str, tenant: str) -> list[str]:
    scoped = tuple(d for d in CORPUS if d.tenant == tenant)
    return [d.id for d in retrieve(query, scoped, 2)]


def rewrite(query: str) -> str:
    if {"checkout", "timeout"} <= terms(query):
        return query + " retry idempotency"
    return query


def rule_pair_score(query: str, doc: Chunk) -> float:
    overlap = terms(query) & terms(doc.text)
    return float(sum(3 if t == "idempotency" else 1 for t in overlap))


def render_chunk(doc: Chunk) -> str:
    return f"[{doc.id};{doc.version}] {doc.text}\n"


def advanced(
    query: str,
    tenant: str,
    scorer: PairScorer = rule_pair_score,
    *,
    budget_bytes: int = 220,
    candidate_k: int = 4,
    final_m: int = 2,
) -> tuple[list[str], str]:
    if not query.strip() or len(query) > 500:
        raise ValueError("query must contain 1..500 characters")
    if budget_bytes <= 0 or candidate_k <= 0 or final_m <= 0:
        raise ValueError("budgets and limits must be positive")
    # tenant is supplied by a trusted caller, never by query rewriting.
    scoped = tuple(d for d in CORPUS if d.tenant == tenant and d.current)
    prepared = rewrite(query)
    candidates = retrieve(prepared, scoped, candidate_k)
    scored = [(scorer(prepared, d), d) for d in candidates]
    if any(not math.isfinite(score) for score, _ in scored):
        raise ValueError("reranker returned a non-finite score")
    scored.sort(key=lambda pair: (-pair[0], pair[1].id))
    selected: list[str] = []
    blocks: list[str] = []
    seen: set[str] = set()
    used = 0
    for _, doc in scored:
        fingerprint = " ".join(doc.text.lower().split())
        if fingerprint in seen:
            continue
        seen.add(fingerprint)
        block = render_chunk(doc)
        size = len(block.encode("utf-8"))
        if used + size > budget_bytes:
            continue  # Skip whole chunk; do not silently cut conditions.
        selected.append(doc.id)
        blocks.append(block)
        used += size
        if len(selected) == final_m:
            break
    return selected, "".join(blocks)


if __name__ == "__main__":
    q = "checkout timeout"
    ids, context = advanced(q, "A")
    print("naive:", naive(q, "A"))
    print("advanced:", ids)
    print(context, end="")
    assert naive(q, "A") == ["duplicate", "generic"]
    assert ids == ["safe", "duplicate"]
    assert len(context.encode("utf-8")) <= 220
    assert "secret" not in ids and "old" not in ids
    assert advanced(q, "A", budget_bytes=1) == ([], "")
    assert advanced("unknownword", "A") == ([], "")
    assert advanced(q, "missing-tenant") == ([], "")
    try:
        advanced(" ", "A")
    except ValueError as exc:
        print("invalid:", exc)
    else:
        raise AssertionError("empty query was accepted")
    print("checks: passed")
Ở đây retrieval vẫn là lexical, còn reranking thêm trọng số theo cặp query–document. Dù cùng dùng từ khóa, hai tầng có trách nhiệm tách biệt: tầng đầu tạo ứng viên, tầng sau thay đổi ưu tiên. Chỉ số K và m không ràng buộc cứng với nhau; packing có thể giữ ít hơn m khi hết dung lượng.
Thứ tự xử lý bảo toàn scope: lọc tenant và tài liệu hiện hành trước retrieval, sau đó mới rewrite và chấm điểm. Principal không xuất hiện trong text rewrite. Demo coi mọi tài liệu hiện hành là v2; hệ thống hỗ trợ đồng thời nhiều phiên bản phải nhận bộ lọc version đã xác nhận, không mặc định loại hết bản cũ cho mọi câu hỏi.
budget_bytes đo chính xác số byte UTF-8 của context đã serialize trong demo, gồm ID, version và newline. Nó không phải token budget của LLM. Khi nối generator, thay phép đếm bằng tokenizer phù hợp và kiểm tra toàn bộ request theo công thức mục 2.4. Nếu bằng chứng quan trọng quá lớn, vòng lặp hiện có thể bỏ nó và giữ đoạn nhỏ kém hữu ích hơn; controller thực cần kiểm tra mức bao phủ bằng chứng trước khi trả lời.
Corpus là tuple và các chunk bất biến; state lựa chọn nằm trong từng lời gọi nên demo không có shared mutable request state. Với n chunk hợp lệ, retrieval quét toàn bộ và sort: khoảng O(n log n), bộ nhớ O(n), không phù hợp index triệu đoạn. Adapter thực cần server-side filtering hoặc index được phân vùng theo quyền; lọc sau top-K toàn cục vừa có nguy cơ lộ dữ liệu cho reranker vừa giảm recall.
Chưa có I/O nên ví dụ không thêm retry hay timeout giả. Khi thay bằng HTTP: đặt timeout từng dịch vụ trong deadline request, giới hạn số cặp đang chạy bằng semaphore/queue, cắt batch theo bộ nhớ model và chỉ retry lỗi tạm thời trong thời gian còn lại. Không cache context hoặc câu trả lời giữa tenant; cache key cần bao gồm quyền, phiên bản index và cấu hình pipeline. Tài liệu truy xuất là dữ liệu không đáng tin: câu “bỏ qua hướng dẫn hệ thống” trong một chunk không được cấp quyền gọi tool hay thay đổi ACL.
3.4. Cách kiểm chứng
Kết quả của bộ dữ liệu tự soạn khi chạy local:
naive: ['duplicate', 'generic']
advanced: ['safe', 'duplicate']
[safe;v2] Payment retry after timeout: keep the same idempotency key. Check transaction status before retrying checkout.
[duplicate;v2] Checkout timeout: inspect network latency and logs.
invalid: query must contain 1..500 characters
checks: passed
Các assertion đã chạy kiểm tra luồng bình thường, context quá nhỏ, không có kết quả, tenant không tồn tại và input rỗng. Thử bổ sung scorer trả float("nan"): lời gọi phải báo ValueError thay vì chọn thứ tự tùy ý. Đầu ra rỗng phải được controller chuyển thành “chưa đủ căn cứ”, không đưa prompt rỗng cho generator rồi gọi đó là grounded answer.
Đây là kiểm thử logic trên fixture nhỏ, không chứng minh reranking tăng độ chính xác ngoài corpus ấy. Chưa chạy embedding, cross-encoder, LLM, vector DB hay tải đồng thời production. Để kiểm chứng những phần đó, chuẩn bị runtime/model được duyệt và tập câu hỏi đã gán chunk bằng chứng, dùng cùng snapshot và chạy ablation:
| Biến thể | Giữ cố định | Đo để quyết định |
|---|---|---|
| Baseline có ACL | Corpus, query, generator | Candidate recall, câu trả lời có căn cứ |
| Thêm query preparation | K và generator | Query drift, recall theo nhóm câu hỏi |
| Thêm reranker | Candidate set đã lưu | MRR@ m, bằng chứng còn lại, thời gian chấm cặp |
| Thêm dedup và packing | Rerank order | Bao phủ điều kiện, token thực, citation support |
| Router hoặc vòng truy xuất | Deadline và tập đánh giá | Giá trị tăng thêm so với độ trễ, lỗi routing, tỷ lệ dừng |
Với tập chunk đúng G và ứng viên C_K, Recall@K = |G ∩ C_K| / |G|; chỉ tính cho câu có G không rỗng. Tách câu không có đáp án để đo abstention riêng. MRR là trung bình nghịch đảo vị trí đoạn đúng đầu tiên, bằng 0 nếu không thấy trong phạm vi đánh giá. Một câu cần hai điều kiện vẫn có thể đạt MRR tốt khi chỉ tìm một điều kiện: bổ sung chỉ số bao phủ toàn bộ bằng chứng bắt buộc.
Không điều chỉnh ngưỡng trên tập test cuối. Lưu query gốc, query rewrite đã che dữ liệu nhạy cảm, candidate IDs, thứ tự sau rerank, đoạn bị bỏ, thời gian từng stage và token thực; hạn chế log nguyên văn tài liệu. Tiêu chí thất bại gồm recall giảm ở mã lỗi hiếm, điều kiện phủ định bị mất, citation trỏ chunk không vào prompt, hoặc p95 vượt ngưỡng đã thống nhất. Nếu thay model mà input của reranker bị truncation, cần đo lại cả retrieval lẫn câu trả lời, không chỉ thông lượng model.
4. Cạm bẫy thực tế và đánh đổi — 注意点とトレードオフ
4.1. Query rewrite làm trôi nghĩa
Triệu chứng: câu hỏi “không retry” tìm ra tài liệu “retry”; tên API hoặc version biến mất. Nguyên nhân: mở rộng query không bảo toàn điều kiện gốc. Phát hiện: so cặp query gốc–rewrite và kiểm thử có phủ định, mã lỗi, tên riêng. Khắc phục: ràng buộc giữ các trường đó, giới hạn số biến thể và giữ một nhánh truy vấn gốc. Chi phí/rủi ro: thêm nhánh làm tăng candidate set và thời gian rerank; nếu hợp nhất không kiểm soát, tài liệu nhiễu có thể lấn át tài liệu đúng.
4.2. Tăng K nhưng vẫn không có bằng chứng
Triệu chứng: generator nhận nhiều đoạn giống nhau nhưng bỏ sót idempotency. Nguyên nhân: index thiếu runbook mới, metadata sai hoặc retriever không khớp thuật ngữ. Phát hiện: xem candidate IDs trước reranker, kiểm tra ingest và Recall@K trên câu đã gán nhãn. Khắc phục: sửa ingest, metadata hoặc nhánh lexical/dense phù hợp; chỉ tăng K khi dữ liệu cho thấy bằng chứng nằm sâu hơn. Chi phí/rủi ro: reindex tốn tài nguyên; K lớn tăng số cặp và queueing. Reranker không phải biện pháp sửa tài liệu chưa được ingest.
4.3. Lọc quyền muộn hoặc dùng cache chung
Triệu chứng: tài liệu tenant B xuất hiện trong log reranker hay trích dẫn tenant A. Nguyên nhân: retrieve toàn cục rồi mới lọc, hoặc cache chỉ theo câu hỏi. Phát hiện: gắn tài liệu canary giữa hai tenant, kiểm tra payload tới mọi dịch vụ và cache hit. Khắc phục: enforce quyền trước retrieval và trước khi gửi ra ngoài; namespace cache theo scope, thu hồi cache khi ACL đổi. Chi phí/rủi ro: cache hit thấp hơn và invalidation khó hơn. Không được fallback sang index không phân quyền khi dịch vụ ACL lỗi.
4.4. Nén context mất điều kiện nghiệp vụ
Triệu chứng: câu trả lời bảo retry nhưng không giữ “cùng idempotency key”. Nguyên nhân: cắt theo ký tự/token hoặc tóm tắt bỏ mệnh đề điều kiện. Phát hiện: gán nhãn từng điều kiện bắt buộc, so context trước–sau nén và đọc trích dẫn cuối. Khắc phục: chọn nguyên đoạn ngắn, giữ câu điều kiện cùng hành động; kiểm tra bao phủ, yêu cầu người dùng làm rõ nếu không đủ. Chi phí/rủi ro: prompt dài hơn hoặc tỷ lệ từ chối cao hơn; chọn nguyên chunk như demo vẫn có thể bỏ cả bằng chứng quá dài.
4.5. Vòng truy xuất không có điểm dừng
Triệu chứng: p95 tăng mạnh, nhiều lần tìm cùng chunk, chi phí request khó dự đoán. Nguyên nhân: router hoặc evaluator luôn quyết định tìm thêm. Phát hiện: trace số vòng, IDs mới trên từng vòng, thời gian chờ queue và tỷ lệ đạt deadline. Khắc phục: giới hạn vòng, tổng candidate và tổng thời gian; dừng khi không thêm bằng chứng hoặc chuyển sang nhân viên. Chi phí/rủi ro: có thể dừng sớm câu hỏi khó; cần ghi rõ giới hạn thay vì hứa tự xử lý mọi trường hợp.
| Phương án | Hiệu năng / độ trễ | Chi phí | Độ phức tạp | Độ tin cậy | Vận hành | Nên chọn khi |
|---|---|---|---|---|---|---|
| Naive có ACL | Ít stage, thường ít điểm chờ | Ít lần gọi; context có thể dư | Thấp | Phụ thuộc trực tiếp chất lượng top-K | Ít module cần theo dõi | Kho nhỏ, câu hỏi rõ, baseline đạt tiêu chí |
| Advanced có rerank/packing | Thêm chấm cặp; generator có thể nhận ít token hơn | Tăng chi phí rerank, có thể giảm input sinh | Vừa | Có thể chọn bằng chứng tốt hơn; cần ablation | Theo dõi từng stage và truncation | Recall đủ nhưng thứ tự/nhiễu là nút thắt |
| Modular có routing/nhánh/vòng | Độ trễ phụ thuộc đường chạy và queue | Biến thiên theo route, số vòng | Cao | Linh hoạt nhưng thêm lỗi router và hợp nhất | Cần version module, trace, budget, fallback | Nhiều kho hoặc loại truy vấn có lợi ích đã đo |
Với SaaS giả định này, bắt đầu bằng ACL, metadata và một pipeline tuyến tính đo được. Thêm reranker khi candidate set có đúng tài liệu nhưng prompt chưa giữ được nó. Chỉ thêm routing/vòng truy xuất khi dữ liệu đánh giá chứng minh các nhóm câu hỏi cần đường xử lý khác nhau. Bảng là phân tích thiết kế định tính, không phải số đo so sánh sản phẩm.
5. Checklist trước khi triển khai — 本番環境への適用前チェック
- Kiểm thử canary xác nhận tài liệu khác tenant/nhóm quyền không đi vào retrieval output, reranker, log, cache hay prompt.
- Corpus có snapshot/version, chủ sở hữu và quy trình thu hồi; query về bản cũ được định nghĩa rõ cách xử lý.
- Tập đánh giá có câu đa ngôn ngữ, phủ định, mã lỗi, nhiều điều kiện và không có đáp án; ngưỡng abstain được chọn ngoài tập test cuối.
- Đếm toàn bộ prompt bằng tokenizer của generator; giữ output reserve và kiểm tra trường hợp chunk đầu vượt ngân sách.
- Có deadline chung, giới hạn K/m/số vòng và số cặp đồng thời; thử lỗi reranker, ACL và generator cùng đường fallback đã duyệt.
- Dashboard theo dõi recall mẫu, citation support, p95 từng stage, token và chi phí/request; log có chính sách che dữ liệu và thời hạn lưu.
- Đã diễn tập rollback cấu hình/index/model và thống nhất với khách hàng mức chất lượng, độ trễ, trường hợp hỏi lại hoặc chuyển nhân viên.
6. Học tiếng Nhật qua chủ đề — 技術日本語を学ぶ
6.1. Sổ tay thuật ngữ RAG và giao tiếp BrSE
Âm Hán Việt ở đây để nhận diện mặt chữ, không thay nghĩa kỹ thuật. Từ katakana không gán âm Hán Việt. Các câu ví dụ được tự biên soạn theo pipeline trên.
| Thuật ngữ Nhật | Furigana | Hán Việt | Nghĩa tiếng Việt / English | Câu ví dụ Nhật | Dịch nghĩa |
|---|---|---|---|---|---|
| 検索 | けんさく | Kiểm sách | Tìm kiếm / retrieval | 検索の前に権限を確認します。 | Kiểm tra quyền trước khi tìm kiếm. |
| 候補 | こうほ | Hậu bổ | Ứng viên / candidate | 候補を40件取得します。 | Lấy 40 ứng viên. |
| 根拠 | こんきょ | Căn cứ | Bằng chứng / evidence | 根拠がなければ、回答を保留します。 | Nếu không có căn cứ thì tạm hoãn trả lời. |
| 権限 | けんげん | Quyền hạn | Quyền truy cập / permission | 権限に基づいて範囲を限定します。 | Giới hạn phạm vi dựa trên quyền. |
| 関連性 | かんれんせい | Quan liên tính | Mức liên quan / relevance | 質問との関連性を再評価します。 | Đánh giá lại mức liên quan với câu hỏi. |
| 再評価 | さいひょうか | Tái bình giá | Đánh giá lại | 候補を再評価してから選択します。 | Đánh giá lại ứng viên rồi mới chọn. |
| 上限 | じょうげん | Thượng hạn | Giới hạn trên / upper limit | 入力の上限を超えないようにします。 | Bảo đảm không vượt giới hạn đầu vào. |
| 検証 | けんしょう | Kiểm chứng | Kiểm chứng bằng thử nghiệm / validation | 同じ条件で効果を検証します。 | Kiểm chứng hiệu quả trong cùng điều kiện. |
| 確認 | かくにん | Xác nhận | Xác nhận thông tin / confirmation | 対象のバージョンを確認させてください。 | Xin cho phép tôi xác nhận phiên bản áp dụng. |
| 保留 | ほりゅう | Bảo lưu | Tạm hoãn / hold | 根拠が不足しているため、回答は保留です。 | Vì thiếu căn cứ nên câu trả lời được tạm hoãn. |
| リランキング | りらんきんぐ | - | Xếp hạng lại / reranking | リランキングの処理時間も計測します。 | Cũng đo thời gian xử lý reranking. |
| コンテキスト | こんてきすと | - | Ngữ cảnh đầu vào / context | コンテキストには文書IDを残します。 | Giữ ID tài liệu trong context. |
確認 và 検証: 確認 dùng để xác nhận phiên bản hay cách hiểu với khách hàng; 検証 phù hợp khi nói kiểm chứng bằng tập đánh giá và phép đo. 関連性 cao không đồng nghĩa tài liệu có thẩm quyền hoặc câu trả lời đúng: các thuộc tính đó cần kiểm tra riêng.
6.2. Ngữ pháp và mẫu diễn đạt
Bảng tổng hợp dùng các mẫu có trong đoạn đọc và hội thoại. Không gán cấp JLPT cố định cho từng mẫu.
| Mẫu | Ý nghĩa | Ví dụ |
|---|---|---|
| ~た上で | Sau khi hoàn tất một bước rồi mới… | 候補を取得した上で、再評価します。— Sau khi lấy ứng viên mới đánh giá lại. |
| ~に応じて | Tùy theo… | 上限に応じて、文書を選びます。— Chọn tài liệu tùy giới hạn. |
| ~とは限らない | Không nhất thiết… | 候補が多ければ正確になるとは限りません。— Nhiều ứng viên chưa chắc chính xác hơn. |
| ~という理解でよろしいでしょうか | Xin xác nhận cách hiểu rằng… | 回答を保留するという理解でよろしいでしょうか。— Hiểu rằng sẽ tạm hoãn trả lời có đúng không? |
A. ~た上で
Cấu trúc: động từ thể た + 上で; danh từ hành động + の上で. Diễn đạt bước trước cần được hoàn tất để ra quyết định sau. Dùng trong review, kế hoạch đánh giá hoặc đề xuất có điều kiện.
- 権限を確認した上で、検索します。— Tìm kiếm sau khi đã kiểm tra quyền.
- 計測結果を比較した上で、リランキングを採用するか判断します。— Sau khi so sánh kết quả đo, quyết định có dùng reranking hay không.
Dễ nhầm: 確認した上で trong kế hoạch không có nghĩa bước kiểm tra đã diễn ra. Muốn báo đã hoàn tất, cần nói rõ kết quả và thời điểm; không dùng cấu trúc chỉ thứ tự làm bằng chứng thực thi.
B. ~に応じて
Cấu trúc: danh từ + に応じて. Lựa chọn hoặc điều chỉnh tùy một yếu tố, thích hợp để giải thích budget hay route.
- 質問の種類に応じて、検索先を切り替えます。— Chuyển nơi tìm kiếm tùy loại câu hỏi.
- 残りの入力枠に応じて、文書数を調整します。— Điều chỉnh số tài liệu tùy phần dung lượng đầu vào còn lại.
Dễ nhầm: không thay ~に基づいて một cách máy móc. 権限に基づいて nhấn mạnh căn cứ bắt buộc; “tùy tải mà có thể bỏ quyền” là sai chính sách dù câu ngữ pháp có vẻ tự nhiên.
C. ~とは限らない
Cấu trúc: mệnh đề thể thường + とは限らない; lịch sự là とは限りません. Phủ nhận một khẳng định mang tính luôn đúng, phù hợp khi giải thích giới hạn.
- コンテキストが長ければ、回答が正確になるとは限りません。— Context dài chưa chắc làm câu trả lời chính xác hơn.
- リランキングを追加しても、必要な根拠が見つかるとは限りません。— Dù thêm reranking cũng chưa chắc tìm thấy căn cứ cần thiết.
Dễ nhầm: mẫu này không khẳng định giải pháp vô ích. Cần nói tiếp điều kiện hoặc phép đo để quyết định, tránh để khách hàng hiểu thành phủ định toàn bộ.
D. ~という理解でよろしいでしょうか
Cấu trúc: nội dung cần xác nhận + という理解でよろしいでしょうか. Lịch sự, phù hợp chốt cách hiểu với khách hàng; với đồng nghiệp thân có thể dùng という理解で合っていますか.
- 現行版のみを対象にするという理解でよろしいでしょうか。— Hiểu rằng chỉ áp dụng bản hiện hành có đúng không?
- 根拠がない場合は、担当者に引き継ぐという理解でよろしいでしょうか。— Hiểu rằng khi không có căn cứ sẽ chuyển cho người phụ trách có đúng không?
Dễ nhầm: câu hỏi xác nhận chưa phải quyết định đã được chấp thuận. Ghi phản hồi vào biên bản trước khi coi đó là điều kiện nghiệm thu.
6.3. Luyện tập ngắn
- Điền mẫu phù hợp: 入力の上限( )、コンテキストを調整します。
- Dịch Việt → Nhật: “Sau khi so sánh kết quả đo, chúng tôi sẽ quyết định có dùng reranking hay không.”
- Sửa câu quá khẳng định sau để nêu đúng giới hạn và bước kiểm chứng: 「リランキングを入れれば、必ず正しく回答できます。」
Đáp án và giải thích:
に応じて: điều chỉnh theo giới hạn. Câu nghĩa là “Điều chỉnh context tùy giới hạn đầu vào”. Không dùngした上でvì上限không phải hành động đã hoàn tất.- 計測結果を比較した上で、リランキングを採用するか判断します。 Cấu trúc giữ rõ thứ tự đo–so sánh–quyết định, chưa hứa triển khai.
- リランキングを追加しても、必ず正確になるとは限りません。評価用の質問で効果を検証します。— Dù thêm reranking cũng chưa chắc luôn chính xác. Chúng tôi sẽ kiểm chứng hiệu quả bằng câu hỏi đánh giá. Bỏ cam kết tuyệt đối và thêm hành động có thể xác minh.
7. Thực hành vai trò BrSE — 現場で伝える
7.1. Tình huống giao tiếp
Vai trò: khách hàng Nhật quản lý nghiệp vụ; BrSE chuyển yêu cầu; Tech Lead chịu trách nhiệm pipeline. Mục tiêu: thống nhất thử nghiệm Advanced RAG trước khi cân nhắc routing. Dữ kiện đã xác nhận trong tình huống giả định: fixture local kiểm tra được việc giữ runbook idempotency; chưa có kết quả model thật hay p95. Điểm còn chưa rõ: phạm vi phiên bản, mức độ trễ chấp nhận, dữ liệu nghiệm thu và chủ sở hữu tài liệu. Hội thoại sau là kịch bản luyện tập, không ghi lại cuộc họp có thật.
- Khách hàng: 決済のタイムアウトについて、安全な対応を案内できるようにしたいです。
Dịch: Chúng tôi muốn hệ thống có thể hướng dẫn cách xử lý an toàn khi thanh toán timeout. - BrSE: まずは現行版の手順書のみを対象にするという理解でよろしいでしょうか。
Dịch: Xin xác nhận giai đoạn đầu chỉ áp dụng các tài liệu quy trình hiện hành, có đúng không? - Khách hàng: はい。旧版への対応は別途検討します。根拠がない場合は、担当者につないでください。
Dịch: Đúng. Việc hỗ trợ bản cũ sẽ bàn riêng. Nếu không có căn cứ, hãy chuyển cho người phụ trách. - Tech Lead: 単純な検索では、似た文書が並び、再試行の条件が抜ける可能性があります。
Dịch: Với tìm kiếm đơn giản, các tài liệu tương tự có thể cùng được chọn và thiếu điều kiện retry. - BrSE: 候補を取得した上で再評価し、条件を含む文書を優先する案です。ただし、処理が増えるため、応答時間も計測します。
Dịch: Phương án là lấy ứng viên rồi đánh giá lại, ưu tiên tài liệu có điều kiện cần thiết. Tuy nhiên, vì tăng bước xử lý nên chúng tôi cũng sẽ đo thời gian phản hồi. - Khách hàng: 候補を増やすだけでは不十分でしょうか。
Dịch: Chỉ tăng số ứng viên thì chưa đủ sao? - Tech Lead: 候補が多ければ正確になるとは限りません。必要な文書が候補に入っているかも別に確認します。
Dịch: Nhiều ứng viên chưa chắc chính xác hơn. Chúng tôi cũng sẽ kiểm tra riêng xem tài liệu cần thiết có nằm trong tập ứng viên hay không. - BrSE: 現時点では、ローカルの制御ロジックのみ検証済みです。実際のモデルでの精度と遅延は、まだ確認できていません。
Dịch: Hiện mới kiểm chứng logic điều phối local. Chúng tôi chưa xác nhận độ chính xác và độ trễ với model thực tế. - Khách hàng: では、こちらで評価用の質問と正しい手順書を用意します。許容できる応答時間も社内で確認します。
Dịch: Vậy phía chúng tôi sẽ chuẩn bị câu hỏi đánh giá và tài liệu quy trình đúng, đồng thời xác nhận nội bộ thời gian phản hồi có thể chấp nhận. - BrSE: 開発側は比較試験を担当します。資料の受領後、評価範囲に応じて日程を調整し、次回のレビューで結果を確認しましょう。
Dịch: Phía phát triển phụ trách thử nghiệm so sánh. Sau khi nhận tài liệu, chúng tôi sẽ điều chỉnh lịch tùy phạm vi đánh giá và cùng xác nhận kết quả ở buổi review tiếp theo.
7.2. Mẫu thông điệp dùng ngay
Thay [資料共有期限] bằng hạn khách hàng chia sẻ dữ liệu và [レビュー日時] bằng thời điểm review đã thống nhất. Đây là hai thông tin người gửi cần điền, không phải lịch đã được chốt trong ví dụ.
本日は、現行版の手順書を対象に、リランキングの有無を比較する方針で合意しました。根拠がない場合は回答を保留し、担当者に引き継ぎます。お客様側には、[資料共有期限]までに評価用の質問と手順書をご共有いただき、許容できる応答時間をご確認いただく予定です。開発側は資料受領後に比較試験を進め、[レビュー日時]に結果と未確認事項をご報告します。
Dịch: Hôm nay đã thống nhất so sánh có và không có reranking trên tài liệu quy trình hiện hành. Khi không có căn cứ, sẽ tạm hoãn trả lời và chuyển người phụ trách. Dự kiến phía khách hàng chia sẻ câu hỏi đánh giá, tài liệu trước [資料共有期限] và xác nhận thời gian phản hồi có thể chấp nhận. Sau khi nhận tài liệu, phía phát triển sẽ tiến hành thử nghiệm so sánh và báo cáo kết quả cùng những điểm chưa xác nhận tại [レビュー日時].
Ba cách diễn đạt đáng học: ~の有無を比較する nói gọn việc so sánh có/không; ~をご確認いただく予定です ghi nhận việc dự kiến phía đối tác thực hiện, chưa báo đã xong; 結果と未確認事項 buộc báo cáo cả phần đã biết và phần còn thiếu.
7.3. Ghi chú dành cho BrSE
- Dịch “reranking cải thiện chất lượng” thành đề xuất cần kiểm chứng, không thành bảo đảm hết hallucination. Tách kết quả fixture local với kết quả model và hạ tầng thật.
- Khi nói “bản mới nhất”, xác nhận đó là tài liệu hiện hành cho sản phẩm nào và người dùng nào. Một runbook v2 đúng với tenant A chưa chắc có thẩm quyền cho tenant B.
- Chốt tiêu chí bằng cả điều kiện nghiệp vụ và phép đo: giữ quy tắc idempotency, trích dẫn đúng, tạm hoãn khi thiếu căn cứ, p95 và chi phí trong tải đã định. “LLM trả lời tự nhiên” không thay được những tiêu chí đó.
Nguồn tham khảo
Các nguồn dưới đây đã được đọc/đối chiếu ngày 17/10/2026. Bài viết phân tích bằng lời riêng; code, corpus, sơ đồ và tiếng Nhật là nội dung tự biên soạn. Không trích benchmark làm kết quả của lần chạy này.
- Yunfan Gao và cộng sự, Retrieval-Augmented Generation for Large Language Models: A Survey, v5, mục II: cách phân loại Naive, Advanced và Modular RAG.
- Patrick Lewis và cộng sự, Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks: nghiên cứu RAG gốc và bộ nhớ tham số/phi tham số.
- Xinbei Ma và cộng sự, Query Rewriting for Retrieval-Augmented Large Language Models: Rewrite–Retrieve–Read.
- Luyu Gao và cộng sự, Precise Zero-Shot Dense Retrieval without Relevance Labels: HyDE và vai trò tài liệu giả định.
- Sentence Transformers, Retrieve & Re-Rank: bi-encoder và cross-encoder trong truy xuất hai tầng.
- Nelson F. Liu và cộng sự, Lost in the Middle: How Language Models Use Long Contexts: độ nhạy theo vị trí trong các thử nghiệm context dài.
- Yunfan Gao và cộng sự, Modular RAG: Transforming RAG Systems into LEGO-like Reconfigurable Frameworks: modular hóa và điều khiển luồng RAG.