Kỹ thuật Chunking và Vector Embedding: Tăng độ chính xác truy xuất
Phân tích semantic chunking, sliding window và lựa chọn embedding model cho dữ liệu Nhật–Việt; thực hành Python, đo độ phủ bằng chứng và luyện trao đổi thiết kế BrSE.
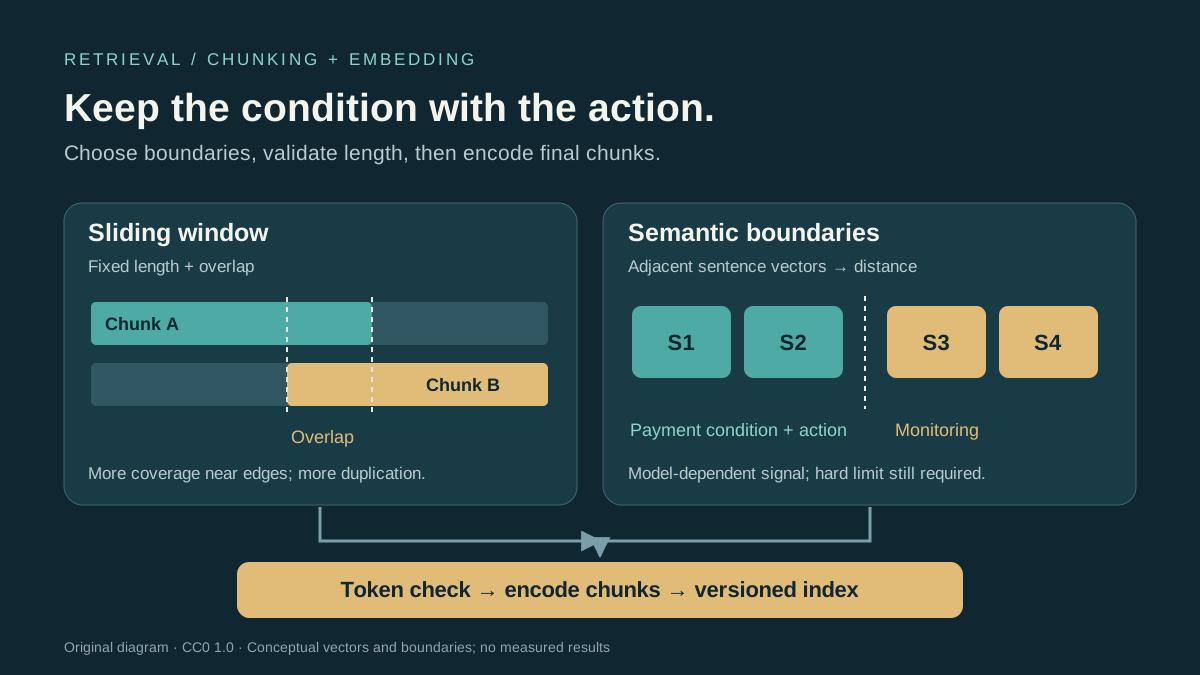
検索精度を高めるチャンク分割とベクトル埋め込み
Giả định: một nhóm SaaS Việt–Nhật xây tìm kiếm trên runbook thanh toán, hướng dẫn giám sát và đặc tả API bằng tiếng Nhật, tiếng Việt và tiếng Anh. Câu hỏi “timeout thì có retry được không?” cần tìm được cả bước kiểm tra trạng thái lẫn điều kiện giữ nguyên idempotency key. Kho tài liệu được phân quyền theo tenant và phiên bản sản phẩm. Đây là tình huống tự biên soạn, không phải sự cố hay benchmark production.
Bài thuộc nhóm AI & Machine Learning, dành cho Senior Software Engineers, Tech Leads, DevOps/SRE, Solution Architects và BrSE. Cần biết Python, vector và quy trình retrieval cơ bản. Tiếng Nhật phù hợp khoảng N3–N2; mọi đoạn Nhật, corpus và ví dụ đều được tự soạn.
Sau bài này, người đọc có thể:
- Giải thích vì sao ranh giới chunk, overlap và truncation ảnh hưởng đến khả năng tìm đủ bằng chứng.
- Hiện thực sliding window, semantic boundary bằng cosine distance, kiểm tra vector lỗi và nối embedding model đa ngôn ngữ.
- Thiết kế thử nghiệm chọn model/chunker và trao đổi điều kiện nghiệm thu bằng tiếng Nhật.
Bài Tối ưu hóa RAG tập trung vào điều phối retrieval, reranking và context. Bài này đi sâu vào đơn vị được index và không gian vector, trước khi reranker nhận ứng viên.
Hero là SVG khái niệm 1200×675 tự vẽ cho bài, phát hành theo CC0 1.0. Đây không phải ảnh đo hiệu năng; alt của hero là tiêu đề bài.
1. Đặt vấn đề và bối cảnh thực tế — なぜ必要なのか
Một runbook có hai câu liên tiếp: “Khi thanh toán timeout, kiểm tra trạng thái giao dịch”; “Nếu retry, sử dụng cùng idempotency key”. Nếu cắt giữa hai câu và chỉ truy xuất câu đầu, tìm kiếm có thể trả tài liệu đúng chủ đề nhưng chưa đủ để hướng dẫn an toàn. Ngược lại, đưa toàn bộ runbook dài vào một vector có thể làm chi tiết về retry khó được phân biệt với phần giám sát log.
Vấn đề có hai tầng: chunking quyết định thông tin nào ở cùng một đơn vị, còn embedding quyết định các đơn vị nằm ở đâu trong không gian tìm kiếm. Đổi model không khôi phục được câu bị parser làm mất; tăng overlap không sửa được việc query được embed bằng một model khác model đã tạo index.
Một baseline cắt cố định vẫn có giá trị: dễ tái lập, ít chi phí ingest và giới hạn dung lượng rõ ràng. Giới hạn xuất hiện khi điều kiện–hành động nằm hai phía ranh giới, tài liệu có nhiều chủ đề hoặc chunk vượt giới hạn tokenizer. Semantic chunking cũng cần được đo: Qu, Tu và Bao đánh giá ba nhóm tác vụ và không thấy lợi ích nhất quán đủ bù chi phí trong thiết lập nghiên cứu của họ. Kết quả ấy không chứng minh semantic chunking luôn kém trên mọi corpus; nó đặt nghĩa vụ kiểm chứng lên thiết kế đang chọn.
Với dự án giả định, tiêu chí gồm độ phủ bằng chứng đúng, độ chính xác của thứ tự kết quả, độ trễ truy xuất p95, thời gian ingest, dung lượng index và chi phí cập nhật. Cần tách tải online khỏi công việc offline: semantic boundary thường tốn thêm embedding lúc ingest, không nhất thiết tạo thêm một lần gọi model trên mỗi query.
Góc nhìn BrSE: khách hàng muốn “tìm đúng tài liệu”, nhưng phải xác nhận đó là tìm đúng tên tài liệu hay tìm đủ đoạn để thực hiện thao tác. Đội cần hỏi: có hỗ trợ câu hỏi Việt truy xuất tài liệu Nhật không, có cần giữ nguyên bảng/code không, phiên bản nào có thẩm quyền, phần nào bị cấm gửi tới embedding service, và điều kiện nào buộc chuyển cho người phụ trách. Các quyết định này ảnh hưởng trực tiếp tới chunker và model shortlist.
2. Bản chất kỹ thuật và cơ chế hoạt động — 仕組みを理解する
2.1. Theo dấu dữ liệu từ tài liệu tới vector
OFFLINE / per authorized document snapshot
raw source -> structural parser -> sections + source offsets + ACL
                                      |
                    +-----------------+------------------+
                    |                                    |
             fixed / sliding                  sentences -> boundary embeddings
                    |                                    |
                    |                           semantic boundaries
                    +-----------------+------------------+
                                      |
                           chunks + token-length check
                                      |
                         passage encoder -> versioned index

ONLINE
identity + query -> query encoder (compatible revision)
                           |
                     scoped vector search
                           |
                 chunk IDs + source spans + scores
                           |
                  dedup / rerank / context
Parser phải giữ bản nguồn hoặc bản văn bản chuẩn hóa có định danh. start/end cần ghi rõ là offset theo byte, Unicode code point hay token; đổi chuẩn hóa sau khi tính offset sẽ làm trích dẫn lệch. Demo dùng offset Unicode code point trong chuỗi Python gốc, không dùng offset byte UTF-8.
Trong thiết kế đề xuất, chunk kế thừa tenant, ACL, document_id, document_revision, section_path và offset. Index snapshot còn ghi model revision, tokenizer, prefix, pooling, normalization và chunker config. Một worker đọc snapshot, tạo chunk, kiểm tra giới hạn, embed rồi ghi vào vùng index mới. Chỉ chuyển traffic khi vùng mới hoàn tất; lỗi giữa batch không được để query đọc một index cập nhật một nửa.
Một khóa ingest có thể được tạo từ định danh tài liệu, revision, offset và cấu hình pipeline. Khóa chỉ dựa vào text hash sẽ gộp nhầm các đoạn giống nhau nhưng có quyền hay nguồn khác nhau. Cache vector có thể tái dùng phép tính trong cùng chính sách dữ liệu; metadata và quyền vẫn phải theo từng nguồn, không được suy ra từ vector.
2.2. Sliding window: overlap mua thêm độ phủ bằng chi phí lặp
Xét tài liệu đã tokenize dài N token. Cửa sổ dài L, overlap O, stride S = L − O, với 0 <= O < L. Nếu không tạo thêm cửa sổ sau khi đã chạm cuối tài liệu:
C = 0                              nếu N = 0
C = 1                              nếu 0 < N <= L
C = 1 + ceil((N - L) / (L - O))     nếu N > L
C là số chunk. Khi N lớn hơn nhiều so với L, lượng token phải embed xấp xỉ N × L / (L − O), chưa tính tiêu đề, prefix và special token được lặp lại. Chẳng hạn giả định tính toán N=1000, L=200, O=50 cho 7 cửa sổ; tổng độ dài các cửa sổ là 1300 token. Đây là kết quả công thức, không phải số đo tốc độ.
Overlap giúp một số câu ở ranh giới cùng xuất hiện trong một cửa sổ. Nó không bảo đảm mọi điều kiện nằm cùng hành động nếu khoảng phụ thuộc dài hơn cửa sổ. Overlap lớn còn làm top-K bị nhiều đoạn gần giống chiếm chỗ. Nếu chỉ tăng K theo số chunk mà không giữ ngân sách context, phép so sánh chất lượng sẽ lẫn với tác động của prompt dài hơn.
Phân biệt hai cách thường bị gọi chung là “window”: sliding window index nhiều đoạn có phần chồng lấn; sentence-window retrieval có thể index từng câu rồi mở rộng các câu lân cận khi trả kết quả. Cách sau giảm số token embed so với index mọi vùng mở rộng, nhưng context gửi generator có thể lớn hơn và phải lọc lại quyền/phiên bản của vùng mở rộng.
2.3. Vector embedding, normalization và metric
Encoder ánh xạ văn bản x thành vector e(x) có d chiều. Một số encoder tạo token embeddings trước, rồi pooling thành một vector cho đoạn. Pooling và prompt đầu vào là một phần của mô hình triển khai; không thể tự đổi mean pooling sang lấy token đầu rồi coi đó là cùng encoder.
Với hai vector khác zero u và v:
cosine(u, v) = sum(u[j] * v[j]) / (norm(u) * norm(v))
unit(u)     = u / norm(u)
cosine(u, v) = dot(unit(u), unit(v))
distance    = 1 - cosine(u, v)     # trong [0, 2], không phải xác suất
Sentence Transformers giải thích quan hệ giữa cosine và dot product trên vector chuẩn hóa. Demo dùng quan hệ này và từ chối vector zero, NaN hoặc sai số chiều. Trong index thật, chọn metric phù hợp với recipe của model; không tự chuẩn hóa một model vốn được thiết kế dùng độ lớn vector mà chưa đánh giá hệ quả.
Hai model cùng trả 384 chiều vẫn có thể tạo hai hệ tọa độ không tương thích. Query phải dùng encoder/recipe tương thích với passage encoder. Không ghép vector của model A và B vào cùng collection chỉ vì cùng dimension. Khi thay model, thường phải tạo lại passage embeddings và chuyển query encoder cùng phiên bản index.
2.4. Semantic chunking: tìm điểm đổi chủ đề, rồi áp giới hạn cứng
Một thuật toán tối thiểu gồm: tách câu, embed câu, tính distance của cặp kề nhau, cắt khi distance vượt ngưỡng, rồi áp giới hạn kích thước. Có thể dùng nhóm câu có buffer để giảm nhiễu từ câu quá ngắn. Mã nguồn SemanticSplitter của LlamaIndex minh họa nhóm câu, cosine dissimilarity và percentile breakpoint. Cần đọc cả implementation khi chọn tham số, không chỉ suy nghĩa từ tên cấu hình.
Ví dụ vector tự đặt: câu 1 và 2 có hướng gần [1, 0], câu 3 và 4 gần [0, 1]. Distance tăng mạnh giữa câu 2 và 3, nên thuật toán tạo hai chunk: thanh toán và giám sát. Kết quả này chỉ kiểm tra phép tính và luồng cắt; không chứng minh model thật hiểu ngữ nghĩa của bốn câu Nhật.
Ngưỡng tuyệt đối và ngưỡng percentile khác nhau. Ngưỡng tuyệt đối cố định giữ cùng tiêu chuẩn distance nhưng nhạy với model/domain. Percentile thích nghi theo phân bố trong tài liệu, nhưng có thể cắt một tài liệu đồng nhất chỉ vì một điểm là lớn nhất tương đối; nếu mọi distance bằng nhau và dùng so sánh >, có thể không có điểm cắt. Cả hai cần max length riêng: không thấy đổi chủ đề không có nghĩa model nhận được đoạn dài vô hạn.
Mô hình dùng cho phát hiện ranh giới câu–câu có thể khác mô hình query–passage retrieval. Khi đó cần version cả hai. Sau khi gộp câu, phải embed lại toàn bộ chunk cuối cho index; không mặc định trung bình vector câu tương đương embedding của văn bản ghép, vì attention và pooling phụ thuộc đầu vào.
2.5. Chọn embedding model theo hợp đồng đầu vào và dữ liệu Nhật–Việt
MTEB đánh giá embedding trên nhiều loại tác vụ. Điểm tổng hợp hữu ích để tạo shortlist, nhưng không thay kiểm thử retrieval trên ngôn ngữ, thuật ngữ và cách hỏi của dự án. Chốt các yếu tố sau trước khi chọn theo leaderboard:
| Yếu tố | Câu hỏi cần trả lời | Bằng chứng cần thu |
|---|---|---|
| Ngôn ngữ | Query Việt có tìm được nguồn Nhật và ngược lại không? | Recall/bao phủ theo từng cặp ngôn ngữ |
| Miền dữ liệu | Có phân biệt API, mã lỗi, phủ định và số phiên bản không? | Cặp đúng–sai gần nghĩa, câu hỏi nghiệp vụ |
| Input recipe | Query/passages dùng prefix, pooling và giới hạn nào? | Model card, config và log token-length |
| Tài nguyên | Batch bao nhiêu vừa RAM/VRAM, p95 online ra sao? | Đo trên máy đích với tải đã thống nhất |
| Vòng đời | Có pin revision, chạy nội bộ, rollback được không? | Manifest index và diễn tập chuyển phiên bản |
| Dữ liệu/quyền dùng | Giấy phép và nơi xử lý phù hợp dự án không? | Điều kiện sử dụng, phê duyệt và luồng dữ liệu thực |
Một ứng viên minh họa là intfloat/multilingual-e5-small. Model card chính chủ mô tả đầu ra 384 chiều, giới hạn 512 token và quy tắc prefix query: / passage: ngay cả với văn bản ngoài tiếng Anh; tác vụ tương đồng đối xứng dùng query: . Đây là thông số tham chiếu ngày 17/10/2026, không phải kết luận model tốt nhất cho Nhật–Việt. Báo cáo Multilingual E5 là nguồn về quá trình huấn luyện và đánh giá dòng model này.
Giới hạn token phải tính trên input thật sau prefix và special tokens, không suy từ số ký tự. Transformers: Padding and truncation phân biệt việc đệm batch với cắt đầu vào dài. Nếu thư viện tự truncate, vector vẫn được trả về nhưng phần cuối chứa điều kiện quan trọng có thể chưa bao giờ được encode. Demo model ở mục 3 kiểm tra độ dài trước để báo lỗi thay vì im lặng chấp nhận.
文書を分割する際は、条件と操作が離れないようにします。隣接する文の類似度に基づいて、分割位置を判断します。ただし、意味が近い場合でも、モデルの入力上限を超えないように分割します。モデルを変更する場合は、インデックスの再構築も必要です。
Dịch: Khi chia tài liệu, cố gắng để điều kiện và thao tác không bị tách xa nhau. Quyết định vị trí cắt dựa trên mức tương đồng giữa các câu kề nhau. Tuy nhiên, ngay cả khi nội dung gần nghĩa, vẫn chia để không vượt giới hạn đầu vào của model. Khi thay model, cũng cần xây dựng lại index.
Chủ thể được lược là hệ thống hoặc đội thiết kế. ~ようにします diễn đạt mục tiêu/cách thực hiện, không chứng minh thuật toán đã bảo đảm đủ mọi điều kiện nghiệp vụ. ただし nêu giới hạn kích thước luôn phải áp dụng.
3. Hiện thực hóa kỹ thuật — 実装する
3.1. Môi trường và cách chạy
Phần chính là chunking_demo.py, dùng Python 3.11+ và thư viện chuẩn; đã chạy trên Python 3.15.0 của môi trường biên soạn. Lưu toàn bộ khối ở mục 3.3 vào một file rồi chạy:
python3 chunking_demo.pyKhông cần model hay mạng để chạy phần này. Nó kiểm tra sliding window, phép toán vector, semantic boundary trên fixture và các lỗi input. Phần mở rộng e5_demo.py nối model thật, cần môi trường riêng và được ghi rõ là chưa chạy suy luận trong lần biên soạn.
3.2. Cách triển khai ban đầu
Baseline dùng sliding(text, size=40, overlap=0). Vì demo tính kích thước bằng Unicode code point, tham số này không phải 40 token. Baseline bao phủ toàn văn nhưng có thể cắt giữa câu. overlap=10 giữ một vùng chồng lấn để giảm một số trường hợp mất liên kết ở ranh giới; chi phí là phần lặp khi embed và khi đưa vào context.
Ví dụ không giả định “40 ký tự là tối ưu”. Cửa sổ nhỏ được chọn để nhìn thấy offset trên fixture 82 ký tự. Bản production cần cửa sổ theo tokenizer thực hoặc parser cấu trúc, rồi kiểm tra độ dài input sau prefix. Không dùng regex của demo để phân tích bảng, source code hay tài liệu PDF nhiều cột.
3.3. Cách triển khai cải tiến
Chương trình dưới giữ Span(start, end) bất biến để trích đúng chuỗi gốc; semantic splitter ghép những câu kề nhau cho tới điểm đổi hướng vector hoặc giới hạn ký tự. Vector fixture được tự đặt, không tạo bằng embedding model. Hàm rank() kiểm tra phép xếp hạng cosine độc lập với chunker.
from dataclasses import dataclass
import math
import re

Vector = list[float]


@dataclass(frozen=True)
class Span:
    start: int
    end: int


def unit(vector: Vector) -> Vector:
    if not vector or any(not math.isfinite(x) for x in vector):
        raise ValueError("vector must contain finite values")
    norm = math.hypot(*vector)
    if norm == 0 or not math.isfinite(norm):
        raise ValueError("vector norm must be finite and positive")
    return [x / norm for x in vector]


def cosine(a: Vector, b: Vector) -> float:
    if len(a) != len(b):
        raise ValueError("embedding dimension mismatch")
    return max(-1.0, min(1.0, sum(x * y for x, y in zip(unit(a), unit(b)))))


def sliding(text: str, size: int, overlap: int) -> list[Span]:
    if size <= 0 or not 0 <= overlap < size:
        raise ValueError("require size > 0 and 0 <= overlap < size")
    spans: list[Span] = []
    start = 0
    while start < len(text):
        end = min(start + size, len(text))
        spans.append(Span(start, end))
        if end == len(text):
            break
        start = end - overlap
    return spans


def sentences(text: str) -> list[Span]:
    # Restricted prose splitter: decimals, code and tables need a real parser.
    spans: list[Span] = []
    for match in re.finditer(r"[^。!?.!?\n]+[。!?.!?]*", text):
        raw = match.group()
        left = len(raw) - len(raw.lstrip())
        right = len(raw.rstrip())
        if left < right:
            spans.append(Span(match.start() + left, match.start() + right))
    return spans


def semantic(
    text: str, vectors: list[Vector], *, threshold: float = 0.4,
    max_chars: int = 80,
) -> list[Span]:
    if not math.isfinite(threshold) or not 0 <= threshold <= 2 or max_chars <= 0:
        raise ValueError("invalid semantic limits")
    parts = sentences(text)
    if len(parts) != len(vectors):
        raise ValueError("one embedding is required per sentence")
    normalized = [unit(v) for v in vectors]
    if normalized and any(len(v) != len(normalized[0]) for v in normalized):
        raise ValueError("embedding dimension mismatch")
    if any(p.end - p.start > max_chars for p in parts):
        raise ValueError("oversized sentence: split structurally before embedding")
    if not parts:
        return []
    chunks: list[Span] = []
    start = parts[0].start
    for i in range(1, len(parts)):
        distance = 1 - cosine(normalized[i - 1], normalized[i])
        if distance > threshold or parts[i].end - start > max_chars:
            chunks.append(Span(start, parts[i - 1].end))
            start = parts[i].start
    chunks.append(Span(start, parts[-1].end))
    return chunks


def rank(query: Vector, documents: list[Vector]) -> list[int]:
    scores = [cosine(query, doc) for doc in documents]
    return sorted(range(len(scores)), key=lambda i: (-scores[i], i))


TEXT = (
    "決済がタイムアウトした場合は、取引状態を確認します。\n"
    "再試行する際は、同じ冪等性キーを使用します。\n"
    "ログは監視サービスに送信します。\n"
    "保存期間は運用規則で定めます。"
)
# Hand-written vectors for control-flow tests, not embeddings from a model.
FIXTURE = [[1.0, 0.0], [0.98, 0.02], [0.0, 1.0], [0.02, 0.98]]

if __name__ == "__main__":
    chunks = semantic(TEXT, FIXTURE)
    print("semantic:", [(s.start, s.end) for s in chunks])
    for span in chunks:
        print(TEXT[span.start:span.end].replace("\n", " / "))
    windows = sliding(TEXT, size=40, overlap=10)
    assert windows[0].start == 0 and windows[-1].end == len(TEXT)
    assert all(b.start == a.end - 10 for a, b in zip(windows, windows[1:]))
    parts = sentences(TEXT)
    assert chunks == [Span(parts[0].start, parts[1].end),
                      Span(parts[2].start, parts[3].end)]
    assert rank([1.0, 0.0], [[0.9, 0.1], [0.1, 0.9]]) == [0, 1]
    assert sliding("", 40, 10) == [] and semantic("", []) == []
    checks = [
        lambda: sliding(TEXT, 40, 40),
        lambda: cosine([0.0, 0.0], [1.0, 0.0]),
        lambda: cosine([1.0], [1.0, 0.0]),
        lambda: semantic(TEXT, FIXTURE[:-1]),
        lambda: semantic(TEXT, FIXTURE, max_chars=5),
        lambda: unit([float("nan")]),
    ]
    for check in checks:
        try:
            check()
        except ValueError:
            pass
        else:
            raise AssertionError("invalid input was accepted")
    print("checks: passed (normal, empty, overlap, dimensions, zero, NaN, oversize)")
semantic() chỉ so các cặp kề nhau, không xây ma trận n×n. Nếu có n câu và vector d chiều, phần tính distance có chi phí O(n×d), chưa tính encoder; lưu embeddings chiếm O(n×d). Hàm demo chuẩn hóa lại khi gọi cosine để ưu tiên tính rõ ràng. Với luồng lớn, có thể chuẩn hóa một lần và dùng dot product, sau khi giữ nguyên các kiểm tra hữu hạn và dimension.
Ranh giới source vẫn cần kiểm toán. Regex có thể tách sai số thập phân, chữ viết tắt và code; câu điều kiện ngắn có thể có vector khác hướng câu hành động. max_chars là giới hạn bảo vệ demo, không thay giới hạn token. Nếu một câu tự nó quá lớn, hàm báo lỗi; worker cần chuyển sang parser/splitter chi tiết hơn và kiểm tra lại, không được âm thầm bỏ câu đó.
Nối model thật — phần tùy chọn chưa chạy suy luận: lưu khối sau thành e5_demo.py bên cạnh chunking_demo.py. Dùng một virtual environment Python 3.11 hoặc 3.12 có runtime PyTorch tương thích; thư viện cần là Sentence Transformers cùng các dependency của nó. Các lệnh này dành cho môi trường thực hành riêng, không thêm dependency vào blog:
python3.11 -m venv .venv
.venv/bin/python -m pip install sentence-transformers
.venv/bin/python -m pip freeze > requirements.lock.txt
.venv/bin/python e5_demo.py
Lệnh cài không pin phiên bản thư viện; file lock ghi môi trường thực tế sau khi cài để tái lập lần chạy tiếp theo. API revision, encode, prompt và normalize_embeddings được đối chiếu với tài liệu SentenceTransformer. Model được pin vào commit có thật fd1525a…, không suy ra từ tên file hoặc tự đặt SHA.
from sentence_transformers import SentenceTransformer
from chunking_demo import TEXT, sentences, semantic, rank

MODEL = "intfloat/multilingual-e5-small"
REVISION = "fd1525a9fd15316a2d503bf26ab031a61d056e98"
model = SentenceTransformer(MODEL, revision=REVISION, device="cpu")
model.max_seq_length = 512


def encode(texts: list[str], role: str) -> list[list[float]]:
    if role not in {"query", "passage"}:
        raise ValueError("role must be query or passage")
    if not texts:
        return []
    if any(not text.strip() for text in texts):
        raise ValueError("empty embedding input")
    prefixed = [f"{role}: {text}" for text in texts]
    tokenized = model.tokenizer(
        prefixed, add_special_tokens=True, truncation=False, padding=False,
    )["input_ids"]
    if any(len(ids) > model.max_seq_length for ids in tokenized):
        raise ValueError("input exceeds model token limit; split before encoding")
    return model.encode(
        prefixed, prompt="", batch_size=8, normalize_embeddings=True,
        convert_to_numpy=True, show_progress_bar=False,
    ).tolist()


parts = sentences(TEXT)
# Symmetric sentence comparison uses query prefix for this E5 model.
boundary_vectors = encode([TEXT[p.start:p.end] for p in parts], "query")
# 0.08 is an experiment setting, not a calibrated production threshold.
spans = semantic(TEXT, boundary_vectors, threshold=0.08, max_chars=80)
chunk_texts = [TEXT[s.start:s.end] for s in spans]
# Re-encode final chunks; do not average sentence vectors for the index.
passages = encode(chunk_texts, "passage")
query = encode(["決済のタイムアウト後に再試行する条件は何ですか。"], "query")[0]
for position in rank(query, passages):
    print(position, chunk_texts[position].replace("\n", " / "))
Adapter chủ động đặt prompt="" vì prefix đã có trong input; không để một prompt mặc định khác được tự cộng thêm sau kiểm tra độ dài. batch_size=8 và CPU là cấu hình thực hành, không phải cấu hình throughput tối ưu. Kết quả ranh giới và thứ tự của model thật chưa được xác nhận; không áp kết quả fixture cho đầu ra này.
Với kho lớn, xử lý theo từng tài liệu/batch có giới hạn, không giữ toàn bộ corpus và embeddings trong một list. Worker cần checkpoint theo snapshot, idempotent upsert, giới hạn queue và chính sách lỗi. Khi gặp OOM, giảm batch hoặc chiều dài sau khi phân tích; không retry vô hạn cùng batch. Nếu gọi embedding API, đặt timeout/deadline và retry có giới hạn cho lỗi tạm thời; không retry lỗi input quá dài hay quyền truy cập bằng cách bỏ kiểm tra.
Embedding không làm dữ liệu hết nhạy cảm. Chỉ gửi tài liệu tới dịch vụ được phép, giữ scope metadata khi index và lọc quyền lúc truy xuất. Index mới phải được kiểm tra count/dimension/config trước khi chuyển traffic. Trạng thái có thể theo parsed → chunked → embedded → indexed → active; tài liệu lỗi nằm ở trạng thái lỗi có bằng chứng, không bị tính là đã index thành công.
3.4. Cách kiểm chứng
Phần thư viện chuẩn đã chạy và trả kết quả sau trên corpus tự soạn:
semantic: [(0, 49), (50, 82)]
決済がタイムアウトした場合は、取引状態を確認します。 / 再試行する際は、同じ冪等性キーを使用します。
ログは監視サービスに送信します。 / 保存期間は運用規則で定めます。
checks: passed (normal, empty, overlap, dimensions, zero, NaN, oversize)
Các assertion kiểm tra semantic grouping theo fixture, window phủ tới cuối tài liệu, stride đúng, xếp hạng vector, input rỗng, overlap không hợp lệ, sai dimension, vector zero/NaN và câu quá dài. Đây là kết quả xác minh logic, không phải benchmark semantic retrieval. Thời gian chạy script nhỏ không được dùng làm p95 tìm kiếm.
Chưa chạy: suy luận E5, ingest vào vector DB, ANN và tải production. Môi trường hiện có Python 3.15.0; chưa chuẩn bị môi trường ML/model cho phần mở rộng. Để kiểm chứng phần đó, cần runtime được hỗ trợ, quyền tải model hoặc model cache và tập query–evidence của dự án. Không có yêu cầu phải dùng GPU cho fixture hoặc ví dụ E5 CPU.
Thiết kế thử nghiệm theo hai vòng. Trước hết giữ model cố định, so chunk cố định không overlap, sliding có overlap và semantic có hard limit. Sau đó giữ chunker cố định, đổi model/recipe. Nếu đổi đồng thời cả hai, khó biết chất lượng thay đổi vì ranh giới hay encoder.
Gán nhãn bằng chứng bằng source span/điều kiện nghiệp vụ, không chỉ bằng chunk ID: chunk ID sẽ đổi khi đổi chunker. Với mỗi câu hỏi, ghi những vùng nguồn bắt buộc để trả lời đủ. Đo tỷ lệ vùng đó được bao phủ trong top-K và trong cùng ngân sách context; overlap trùng nhau chỉ được tính một lần. Có thể báo thêm MRR hoặc nDCG để xem thứ tự, nhưng một đoạn đúng đứng đầu chưa đủ nếu câu hỏi cần hai điều kiện.
| Nhóm phép thử | Giữ cố định | Cần ghi lại |
|---|---|---|
| Ranh giới chunk | Snapshot, tokenizer, encoder | Vùng bằng chứng bị cắt, độ dài p50/p95, số đoạn quá giới hạn |
| Overlap | L, model, context budget | Token embed lặp, nguồn trùng top-K, độ phủ độc nhất |
| Embedding model | Chunker, query, scope | Recall/bao phủ theo Nhật→Việt, Việt→Nhật và cùng ngôn ngữ |
| Index tìm kiếm | Vectors và query encoder | Kết quả brute-force exact so với ANN, latency theo tải |
| Cập nhật model/index | Bộ câu hỏi nghiệm thu | Count, dimension, manifest, khả năng rollback và quyền truy cập |
Dùng exact search làm đối chứng trước khi điều chỉnh ANN: nếu exact cũng không thấy bằng chứng thì tăng tham số ANN khó giải quyết. Không chọn threshold trên tập test cuối. Dấu hiệu thất bại gồm các câu có phủ định bị truy xuất như khẳng định, mã lỗi hiếm mất recall, token ở cuối bị truncate, hoặc chất lượng tốt lên chỉ vì context budget tăng.
4. Cạm bẫy thực tế và đánh đổi — 注意点とトレードオフ
4.1. Chunk đúng chủ đề nhưng thiếu điều kiện
Triệu chứng: kết quả có “retry payment” nhưng không có yêu cầu giữ idempotency key. Nguyên nhân: ranh giới cắt tách điều kiện khỏi hành động, hoặc parser mất chú thích bảng. Phát hiện: đánh giá theo source span và đọc các trường hợp thiếu điều kiện; không chỉ xem tiêu đề tài liệu. Khắc phục: chia theo section/quy trình, giữ câu phụ thuộc hoặc mở rộng vùng lân cận có cùng quyền và version. Chi phí/rủi ro: đoạn dài hơn có thể làm embedding ít phân biệt và context tốn thêm token; việc mở rộng cần kiểm tra token limit lần nữa.
4.2. Semantic splitter tạo quá nhiều hoặc quá ít chunk
Triệu chứng: nhiều chunk chỉ có một câu ngắn, hoặc cả chương dài bị gộp thành một đoạn. Nguyên nhân: threshold không phù hợp phân bố, câu nối phụ thuộc ngữ cảnh, hoặc chỉ dùng percentile mà không giới hạn kích thước. Phát hiện: xem histogram độ dài, distance và ví dụ quanh breakpoint; theo dõi số lần đụng hard limit. Khắc phục: hiệu chỉnh threshold, buffer và cấu trúc trước khi embed; giữ max token bắt buộc. Chi phí/rủi ro: tăng embedding lúc ingest, phải version cấu hình và reindex khi đổi ranh giới. Buffer lớn cũng có thể làm mờ chuyển chủ đề.
4.3. Overlap làm đẹp Recall@K nhưng không thêm thông tin
Triệu chứng: top-10 chứa nhiều đoạn gần giống nhau, mỗi kết quả đều được tính là “đúng”. Nguyên nhân: nhãn theo chunk ID và không gộp phần bằng chứng trùng. Phát hiện: ánh xạ kết quả về source span, tính độ phủ hợp của các vùng và số document độc nhất. Khắc phục: đánh giá span độc nhất, dedup theo nguồn/offset phù hợp và so trong cùng context budget. Chi phí/rủi ro: dedup quá mạnh có thể loại bản dịch hoặc bản khác phiên bản thật sự cần thiết; không gộp xuyên tenant chỉ vì text giống nhau.
4.4. Truncation âm thầm và prefix không nhất quán
Triệu chứng: embedding thành công nhưng câu hỏi về phần cuối tài liệu luôn tìm kém; đổi môi trường thì ranking thay đổi lớn. Nguyên nhân: input dài bị tự cắt, query/passage thiếu prefix hoặc bị thêm prefix hai lần. Phát hiện: log số token trước encode, kiểm tra input recipe và test thay đổi riêng đoạn cuối. Khắc phục: kiểm tra token với đúng tokenizer, prefix và special tokens; từ chối hoặc chia lại input quá dài. Chi phí/rủi ro: thêm bước tokenize và xử lý lỗi; cắt lại có thể đổi toàn bộ chunk IDs, cần kế hoạch cập nhật index.
4.5. Thay model nhưng giữ vector cũ
Triệu chứng: index vẫn nhận query, dimension không lỗi nhưng chất lượng giảm sau deploy. Nguyên nhân: query encoder mới truy xuất passage embeddings cũ, hoặc pooling/normalization khác nhau. Phát hiện: đối chiếu manifest hai phía, kiểm tra exact retrieval trên bộ cố định và so vector checksum/tolerance theo môi trường. Khắc phục: index mới tách biệt, embed lại tài liệu rồi chuyển query encoder cùng snapshot; giữ đường rollback tương thích. Chi phí/rủi ro: có giai đoạn lưu hai index, tăng ingest và storage; cần thử cả cache invalidation, cập nhật quyền và tài liệu thay đổi trong lúc xây index.
| Phương án | Hiệu năng và chi phí | Độ phức tạp | Độ tin cậy | Khả năng vận hành | Điều kiện nên chọn |
|---|---|---|---|---|---|
| Fixed-size, không overlap | Ingest đơn giản; ít phần lặp | Thấp | Dễ kiểm soát kích thước, dễ cắt mất quan hệ | Dễ tái lập và debug | Baseline hoặc tài liệu có đơn vị đều, đã đạt nghiệm thu |
| Sliding có overlap | Tăng token embed và kích thước index theo stride | Thấp–vừa | Giảm một số lỗi ranh giới, có kết quả trùng | Cần dedup và quan sát chi phí lặp | Lỗi chủ yếu ở vùng sát ranh giới |
| Structural theo section/câu | Chi phí parser; số chunk tùy cấu trúc | Vừa | Giữ cấu trúc tốt nếu parser đúng | Cần xử lý bảng/code/PDF và version parser | Nguồn có cấu trúc ổn định, quy trình nhiều điều kiện |
| Semantic có hard limit | Thêm boundary embeddings; online tùy số chunk/index | Cao hơn | Phụ thuộc model, threshold và ngôn ngữ | Theo dõi phân bố, reindex và cấu hình model | Đã đo được lợi ích trên tài liệu nhiều chủ đề |
Bảng phân tích định tính, không phải benchmark các thư viện. Với runbook của tình huống này, nên bắt đầu bằng parser giữ section và kiểm tra token, dùng sliding làm baseline, rồi thử semantic khi dữ liệu cho thấy điểm đổi chủ đề có ích. Chọn model nhẹ hay lớn hơn phải dựa trên độ phủ bằng chứng và tải đo được, không chỉ dựa dimension.
Ước lượng storage thô cho N chunk, d chiều và float32 là N × d × 4 byte. Ví dụ tự tính một triệu vector 384 chiều chiếm 1.536.000.000 byte, khoảng 1,43 GiB cho giá trị vector. Chưa gồm cấu trúc ANN, text, metadata, bản sao, WAL hay index cũ khi chuyển phiên bản. Không dùng con số này làm cấu hình RAM duy nhất.
5. Checklist trước khi triển khai — 本番環境への適用前チェック
- Bộ kiểm tra parser xác nhận giữ nguyên điều kiện, bảng/code cần thiết và offset truy về đúng revision của nguồn sau chuẩn hóa.
- Token-length được đo trên input sau prefix/special tokens; có test input ở giới hạn, vượt giới hạn và phần bằng chứng ở cuối đoạn.
- Index manifest pin model/tokenizer, prefix, pooling, normalization, dimension và cấu hình chunker; query encoder kiểm tra tính tương thích.
- Tập đánh giá có Nhật→Việt, Việt→Nhật, mã lỗi, phủ định và câu cần nhiều vùng bằng chứng; chấm theo span độc nhất và cùng context budget.
- Quyền truy cập được truyền vào mọi chunk và áp lúc retrieval/mở rộng vùng; embedding service, cache và log tuân thủ phạm vi dữ liệu đã duyệt.
- Đã đo ingest, batch RAM/VRAM, index size, p95 truy xuất và tỷ lệ duplicate; worker có checkpoint, giới hạn concurrency và đường xử lý input lỗi.
- Đã diễn tập tạo index mới, chuyển query encoder và rollback; khách hàng xác nhận điều kiện nghiệm thu và cách xử lý khi chưa tìm đủ bằng chứng.
6. Học tiếng Nhật qua chủ đề — 技術日本語を学ぶ
6.1. Sổ tay thuật ngữ chunking, embedding và giao tiếp BrSE
Cột Hán Việt dùng để nhận diện Kanji. Với từ thuần Nhật hoặc từ ghép có cách đọc không phù hợp cách ghi Hán Việt, dùng -. Các ví dụ bên dưới tự soạn theo thiết kế của bài.
| Thuật ngữ Nhật | Furigana | Hán Việt | Nghĩa tiếng Việt / English | Câu ví dụ Nhật | Dịch nghĩa |
|---|---|---|---|---|---|
| 分割 | ぶんかつ | Phân cát | Chia nhỏ / splitting | 文書を意味のまとまりで分割します。 | Chia tài liệu theo các đơn vị có ý nghĩa. |
| 境界 | きょうかい | Cảnh giới | Ranh giới / boundary | 境界の前後も確認します。 | Cũng kiểm tra phần trước và sau ranh giới. |
| 重複 | ちょうふく | Trùng phức | Trùng lặp / duplication | 検索結果の重複を計測します。 | Đo phần trùng lặp trong kết quả tìm kiếm. |
| 類似度 | るいじど | Loại tự độ | Mức tương đồng / similarity | 隣接する文の類似度を比較します。 | So sánh mức tương đồng giữa các câu kề nhau. |
| 埋め込み | うめこみ | - | Biểu diễn nhúng / embedding | 埋め込みモデルのバージョンを固定します。 | Cố định phiên bản embedding model. |
| 次元 | じげん | Thứ nguyên | Số chiều / dimension | 次元が同じでも、モデルは互換とは限りません。 | Dù cùng số chiều, các model chưa chắc tương thích. |
| 正規化 | せいきか | Chính quy hóa | Chuẩn hóa / normalization | ベクトルの正規化を統一します。 | Thống nhất cách chuẩn hóa vector. |
| 切り捨て | きりすて | - | Cắt bỏ / truncation | 末尾の切り捨てを検出します。 | Phát hiện việc cắt bỏ phần cuối. |
| 再構築 | さいこうちく | Tái cấu trúc | Xây dựng lại / rebuild | 変更後にインデックスを再構築します。 | Xây dựng lại index sau khi thay đổi. |
| 比較 | ひかく | Tỉ giảo | So sánh / comparison | 同じ条件で比較します。 | So sánh trong cùng điều kiện. |
| 検証 | けんしょう | Kiểm chứng | Kiểm chứng bằng thử nghiệm / validation | 実データで効果を検証します。 | Kiểm chứng hiệu quả trên dữ liệu thực. |
| 合意 | ごうい | Hợp ý | Thống nhất / agreement | 受入条件について合意します。 | Thống nhất về điều kiện nghiệm thu. |
類似度 và 関連性: câu giống nghĩa chưa chắc là bằng chứng liên quan và đủ để trả lời một câu hỏi cụ thể. Cặp “không được retry” và “được retry” có thể gần nhau trong không gian embedding, nhưng khác quyết định nghiệp vụ. 比較 và 検証: so sánh là thao tác đối chiếu; kiểm chứng cần giả thuyết, dữ liệu và tiêu chí. Không báo “đã kiểm chứng model” khi mới chỉ xem hai kết quả tìm kiếm.
6.2. Ngữ pháp và mẫu diễn đạt
Các mẫu dùng ngay trong review chunker và kế hoạch đánh giá. Không gán mức JLPT cố định cho từng mẫu.
| Mẫu | Ý nghĩa | Ví dụ |
|---|---|---|
| ~際に | Khi thực hiện… | 分割する際に、条件を残します。— Khi chia, giữ lại điều kiện. |
| ~に基づいて | Dựa trên căn cứ… | 類似度に基づいて判断します。— Quyết định dựa trên mức tương đồng. |
| ~ようにする | Cố gắng/bố trí để đạt trạng thái… | 上限を超えないようにします。— Bố trí để không vượt giới hạn. |
| ~一方で | Trong khi đó / mặt khác… | 重複を減らせる一方で、処理は複雑になります。— Giảm được trùng lặp, đồng thời xử lý phức tạp hơn. |
A. ~際に
Cấu trúc: động từ thể từ điển/た + 際に; danh từ + の際に. Nghĩa là “khi/dịp”, trang trọng hơn とき, phù hợp mô tả thao tác hay quy trình cho khách hàng.
- モデルを変更する際に、インデックスも再構築します。— Khi thay model, cũng xây dựng lại index.
- 評価の際に、日本語とベトナム語を分けて集計します。— Khi đánh giá, thống kê riêng tiếng Nhật và tiếng Việt.
Dễ nhầm: 変更した際に đặt hành động thay đổi ở thể đã hoàn tất trong mệnh đề, nhưng cả câu có thể đang mô tả quy trình tương lai. Không dùng riêng thể た để kết luận công việc đã được thực hiện.
B. ~に基づいて
Cấu trúc: danh từ + に基づいて; đứng trước danh từ là ~に基づく. Nhấn mạnh căn cứ để quyết định, dùng khi giải thích lựa chọn kỹ thuật bằng dữ liệu.
- 計測結果に基づいて、チャンクの長さを決めます。— Quyết định độ dài chunk dựa trên kết quả đo.
- 権限に基づく検索範囲を維持します。— Duy trì phạm vi tìm kiếm dựa trên quyền truy cập.
Dễ nhầm: căn cứ phải tồn tại. Nếu chưa đo, nói 計測結果に基づいて判断する予定です — dự kiến quyết định dựa trên kết quả đo — thay vì dùng câu khiến người nghe tưởng đã có kết quả.
C. ~ようにする
Cấu trúc: động từ thể từ điển/ない + ようにする. Diễn đạt chủ động bố trí hoặc cố gắng đạt một trạng thái. Dùng để mô tả mục tiêu thiết kế; với bảo đảm kỹ thuật, cần nói thêm cơ chế kiểm tra.
- 条件と操作が離れないようにします。— Cố gắng để điều kiện và thao tác không bị tách xa nhau.
- 入力が上限を超えた場合は、エラーにするようにします。— Bố trí để báo lỗi khi đầu vào vượt giới hạn.
Dễ nhầm: mục tiêu giữ nghĩa không tự trở thành bảo đảm. Hãy nêu “đã kiểm tra source span và trường hợp phủ định” nếu thật sự có bằng chứng, thay vì dùng ようにします để hứa không bao giờ mất thông tin.
D. ~一方で
Cấu trúc: động từ/tính từ い thể thường + 一方で; tính từ な + な一方で; danh từ + である一方で. Dùng trình bày hai khía cạnh song song, đặc biệt hữu ích khi giải thích trade-off.
- 重複部分を増やすと境界の情報を残しやすくなる一方で、保存量も増えます。— Tăng overlap giúp dễ giữ thông tin ở ranh giới, đồng thời làm tăng lượng lưu trữ.
- 軽量モデルは運用しやすい一方で、必要な精度を満たすか検証が必要です。— Model nhẹ dễ vận hành, đồng thời cần kiểm chứng xem có đạt độ chính xác yêu cầu hay không.
Dễ nhầm: 一方で không tự nói phương án nào thắng. Sau khi nêu hai mặt, cần nối với ràng buộc dự án và tiêu chí lựa chọn; không khẳng định mọi model nhẹ đều kém chính xác.
6.3. Luyện tập ngắn
- Điền mẫu: 計測結果( )、分割方法を決めます。
- Dịch Việt → Nhật: “Khi thay embedding model, chúng tôi cũng sẽ xây dựng lại index.”
- Sửa câu quá khẳng định sau bằng cách nêu giới hạn và bước tiếp theo: 「意味で分割すれば、必ず検索精度が上がります。」
Đáp án và giải thích:
に基づいて. Câu nghĩa là “Quyết định phương pháp chia dựa trên kết quả đo”. Nếu chưa có số đo, thêm予定ですđể diễn đạt kế hoạch.- 埋め込みモデルを変更する際に、インデックスも再構築します。 Mẫu
際にđặt hai việc trong cùng quy trình thay đổi. - 意味に基づく分割が有効かどうかは、文書とモデルによって異なります。同じ条件で比較します。— Việc chia dựa trên ngữ nghĩa có hiệu quả hay không tùy tài liệu và model. Chúng tôi sẽ so sánh trong cùng điều kiện. Bỏ cam kết “nhất định tăng” và thêm phép kiểm chứng cụ thể.
7. Thực hành vai trò BrSE — 現場で伝える
7.1. Tình huống giao tiếp
Vai trò: khách hàng Nhật phụ trách tài liệu nghiệp vụ, BrSE làm rõ tiêu chí, Tech Lead phụ trách ingest và retrieval. Mục tiêu: chốt thử nghiệm chunker/model cho runbook Nhật–Việt. Đã xác nhận trong ví dụ: fixture local kiểm tra được offset, overlap và lỗi vector. Chưa rõ: chất lượng E5 trên dữ liệu thật, ngân sách p95 và số tài liệu cần cập nhật mỗi ngày. Cuộc trao đổi dưới đây là tình huống luyện tập tự soạn.
- Khách hàng: ベトナム語の質問でも、日本語の手順書を見つけられるようにしたいです。
Dịch: Chúng tôi muốn câu hỏi tiếng Việt cũng tìm được tài liệu quy trình tiếng Nhật. - BrSE: 文書名だけでなく、再試行の条件まで確認できることが必要でしょうか。
Dịch: Yêu cầu là không chỉ tìm tên tài liệu mà còn xác nhận được cả điều kiện retry, đúng không? - Khách hàng: はい。同じ冪等性キーを使うという条件が抜けると困ります。
Dịch: Đúng. Nếu thiếu điều kiện dùng cùng idempotency key thì sẽ có vấn đề. - Tech Lead: 固定長で分割すると、その条件が別のチャンクに入る可能性があります。まず、分割位置を確認します。
Dịch: Nếu cắt theo độ dài cố định, điều kiện ấy có thể nằm ở chunk khác. Trước tiên chúng tôi sẽ kiểm tra vị trí cắt. - BrSE: 重複部分を設ける方法と、意味に基づく分割を比較します。後者は文書登録時の処理が増える可能性があります。
Dịch: Chúng tôi sẽ so sánh phương pháp có overlap với phương pháp chia theo ngữ nghĩa. Phương pháp sau có thể tăng xử lý lúc đăng ký tài liệu. - Khách hàng: 多言語モデルなら、そのまま使えますか。
Dịch: Nếu là model đa ngôn ngữ thì dùng ngay được không? - Tech Lead: 候補にはなりますが、実データでの評価が必要です。モデルを変更する際は、インデックスも作り直します。
Dịch: Model đó có thể là ứng viên, nhưng cần đánh giá trên dữ liệu thực. Khi thay model, chúng tôi cũng sẽ làm lại index. - BrSE: 現在は制御ロジックの検証まで完了しています。モデルの精度と検索のp95は未確認です。
Dịch: Hiện đã kiểm chứng xong logic điều phối. Độ chính xác của model và p95 tìm kiếm chưa được xác nhận. - Khách hàng: こちらで質問例と、回答に必要な箇所を用意します。更新件数も確認します。
Dịch: Phía chúng tôi sẽ chuẩn bị câu hỏi mẫu và các vùng nguồn cần thiết để trả lời, đồng thời xác nhận số tài liệu cập nhật. - BrSE: 開発側で同じ入力条件で比較します。資料をいただいた後に日程を確定し、次回レビューで計測結果に基づいて受入条件を合意しましょう。
Dịch: Phía phát triển sẽ so sánh trong cùng điều kiện đầu vào. Sau khi nhận tài liệu, chúng tôi sẽ chốt lịch và cùng thống nhất điều kiện nghiệm thu dựa trên kết quả đo tại buổi review tiếp theo.
7.2. Mẫu thông điệp dùng ngay
[資料共有日] là ngày khách hàng cung cấp dữ liệu; [レビュー日時] là ngày giờ review. Người gửi cần điền hai mốc đã được thống nhất; đây không phải lịch có thật của dự án.
本日は、固定長・重複あり・意味に基づく分割を、同じモデルと入力枠で比較する方針を確認しました。お客様側には[資料共有日]までに質問例と根拠箇所をご共有いただく予定です。開発側は受領後に試験を実施し、[レビュー日時]に結果をご報告します。モデルの実測精度とp95は未確認であり、受入条件は計測後に合意する予定です。
Dịch: Hôm nay đã xác nhận phương hướng so sánh cắt cố định, có overlap và dựa trên ngữ nghĩa với cùng model và ngân sách đầu vào. Dự kiến phía khách hàng chia sẻ câu hỏi mẫu và vùng căn cứ trước [資料共有日]. Sau khi nhận, phía phát triển sẽ thực hiện thử nghiệm và báo cáo tại [レビュー日時]. Độ chính xác đo thực tế của model và p95 chưa được xác nhận; dự kiến thống nhất điều kiện nghiệm thu sau khi đo.
Ba cách diễn đạt đáng học: 方針を確認しました xác nhận phương hướng, chưa nói thử nghiệm đã xong; 根拠箇所 chỉ đúng vùng bằng chứng, rõ hơn yêu cầu gửi “tài liệu liên quan”; 未確認であり phân biệt phần chưa biết với kết quả đã thực hiện, phù hợp báo cáo chính thức. Chat nội bộ có thể dùng câu ngắn hơn nhưng vẫn giữ mức chắc chắn đó.
7.3. Ghi chú dành cho BrSE
- Khi dịch “semantic”, giải thích đó là một cách chọn ranh giới theo tín hiệu model. Không biến thành lời hứa hệ thống luôn giữ được toàn bộ ý nghĩa hoặc loại bỏ hallucination.
- Xác nhận “độ dài chunk” dùng đơn vị nào: ký tự, token của embedding model hay token của generator. Giới hạn và tokenizer của hai model có thể khác; phải ghi cả prefix và metadata được thêm.
- Chốt rằng thay model có thể kéo theo reindex, storage tạm thời và lịch chuyển phiên bản. Khách hàng cần hiểu công việc gồm cả dữ liệu/index và query encoder, không chỉ đổi một tên model trong cấu hình.
Nguồn tham khảo
Nguồn được đọc/đối chiếu ngày 17/10/2026. Phần phân tích, công thức minh họa, fixture, code và câu Nhật được tự biên soạn. Chỉ kết quả logic thư viện chuẩn ở mục 3.4 đã được chạy; không nhận các kết quả nghiên cứu hay điểm model card là số đo của bài này.
- Renyi Qu, Ruixuan Tu, Forrest Bao, Is Semantic Chunking Worth the Computational Cost?: đánh giá semantic chunking và giới hạn kết luận theo thiết lập thử nghiệm.
- LlamaIndex, Semantic splitter và mã nguồn: nhóm câu, cosine dissimilarity và percentile breakpoint.
- Sentence Transformers, Semantic Textual Similarity: cosine, dot product và normalization.
- Sentence Transformers, SentenceTransformer API: revision, prompt và encode API dùng ở phần mở rộng.
- intfloat, Multilingual-E5-small model card và commit được pin trong ví dụ: prefix và giới hạn đầu vào của model minh họa.
- Liang Wang và cộng sự, Multilingual E5 Text Embeddings: A Technical Report: bối cảnh huấn luyện và đánh giá dòng E5 đa ngôn ngữ.
- Niklas Muennighoff và cộng sự, MTEB: Massive Text Embedding Benchmark: đánh giá embedding trên nhiều loại tác vụ.
- Hugging Face Transformers, Padding and truncation: đệm batch và cắt input dài.