Quantization LLM (GGUF, AWQ, GPTQ): Chạy mô hình lớn trên Edge AI
Hiểu lượng tử hóa 4-bit/8-bit, phân biệt GGUF với AWQ/GPTQ, tính bộ nhớ KV và kiểm chứng chất lượng–tốc độ; kèm Python và thực hành BrSE Nhật–Việt.
LLMの量子化:品質と速度を両立するには
Bối cảnh giả định: nhóm phát triển trợ lý tra cứu tài liệu Nhật–Việt chạy offline trên máy tại nhà máy. Ta xét mô hình decoder-only có trọng số được phép sử dụng, một phiên tương tác ban đầu và RAM/VRAM hữu hạn. Ví dụ toán dùng Python chuẩn; phần triển khai tham chiếu llama.cpp, AWQ và GPTQ. Bài dành cho kỹ sư có kiến thức tensor, phép nhân ma trận và inference; tiếng Nhật phù hợp khoảng N3–N2, không dùng nhãn đó để khẳng định cấp JLPT từng từ.
Sau bài này, bạn có thể phân biệt định dạng với thuật toán lượng tử hóa, tính ngân sách bộ nhớ có KV cache và thiết kế phép thử 4-bit/8-bit có tiêu chí chất lượng. Bạn cũng luyện cách giải thích với khách hàng vì sao “file nhỏ hơn” chưa đủ để cam kết “trả lời nhanh hơn”. Các tình huống, câu Nhật, số liệu giả định và mã minh họa đều do bài tự biên soạn; không phải trích nguyên văn hoặc benchmark của các paper.
1. Đặt vấn đề và bối cảnh thực tế — なぜ必要なのか
Khách hàng muốn tra cứu được khi mất kết nối và không gửi tài liệu ra ngoài. Bản FP16 tải được trên máy phát triển nhưng không vừa bộ nhớ của thiết bị đích. Đội đề xuất “đổi sang 4-bit”, trong khi người dùng còn muốn đưa nhiều trang hướng dẫn vào context và nhận câu trả lời tiếng Nhật đúng thuật ngữ.
Ba yêu cầu này dùng chung tài nguyên. Nén trọng số giảm một phần bộ nhớ; context dài làm KV cache lớn hơn; runtime có thể cần buffer hoặc chuyển layer giữa CPU và GPU. Nếu chỉ nhìn dung lượng file, nhóm có thể chọn bản vừa lúc khởi động nhưng hết bộ nhớ khi sinh token. Offline cũng cần xác nhận đường đi của log, telemetry và cập nhật model; lượng tử hóa tự nó không kiểm soát các đường đó.
Trước khi chọn phương án, BrSE cần chốt: thiết bị/RAM dùng chung với ứng dụng nào, số phiên đồng thời, giới hạn input/output token, thời gian đến token đầu tiên (TTFT), độ trễ giữa token (ITL), và các lỗi chất lượng không được chấp nhận. “Giữ nguyên độ chính xác” cần chuyển thành tập câu hỏi, rubric và ngưỡng hồi quy, không dùng một câu trả lời mẫu làm nghiệm thu.
Quy tắc quyết định của bài: trong các artifact vượt qua cổng chất lượng và tương thích runtime, chọn artifact đáp ứng bộ nhớ đỉnh, latency và điện năng trên đúng thiết bị. Đây là phương pháp thử nghiệm được đề xuất, không phải kết luận rằng 4-bit hoặc 8-bit luôn thắng.
2. Bản chất kỹ thuật và cơ chế hoạt động — 仕組みを理解する
2.1. Từ số thực tới mã nguyên và trở lại
Lượng tử hóa biểu diễn nhiều giá trị thực bằng một tập hữu hạn mã. Với phép lượng tử hóa affine đơn giản, đặt s > 0 là scale, z là zero-point, qmin/qmax là biên mã:
- Mã hóa:
q = clip(round(w / s) + z, qmin, qmax). - Giải lượng tử:
w_hat = s × (q − z). - Sai số:
e = w − w_hat. Nếu không clipping và làm tròn tới mức gần nhất, sai số tuyệt đối không quás/2trong số học chính xác.
Ví dụ đối xứng dùng z = 0, 4-bit với dải −7…7 (chủ động bỏ mã −8), s = max(abs(w))/7. Khi giá trị lớn nhất là 7, trọng số 0,3 thành 0: sai số 0,3. 8-bit dùng −127…127, tạo lưới dày hơn nếu cùng miền giá trị. Tuy vậy, độ lệch một trọng số chưa nói lên độ lệch câu trả lời: tác động ở lớp tuyến tính là (W − W_hat)X, còn các lớp sau tiếp tục biến đổi sai số.
Granularity quyết định ai dùng chung scale. Per-tensor dùng một scale cho cả tensor; per-channel chia theo kênh; group-wise chia các nhóm hữu hạn. Một outlier có thể kéo scale của cả nhóm lên và làm mất các trọng số nhỏ. Nhóm nhỏ hạn chế ảnh hưởng này nhưng tốn metadata và có thể đổi đặc tính kernel. Clipping giảm ảnh hưởng outlier nhưng tạo sai số lớn ở các điểm bị cắt; ngưỡng phải được đánh giá theo output, không chọn chỉ vì biểu đồ trọng số đẹp.
Ở đây 4-bit/8-bit nói về cách lưu trọng số. W4A16 nghĩa là trọng số 4-bit, activation 16-bit; accumulator và KV cache có kiểu riêng. Không suy ra toàn bộ GPU đang nhân số nguyên 4-bit. Ví dụ Python ở mục 3 minh họa phép toán và metadata, không phải bản cài đặt bit-exact của Q4_K, AWQ hoặc GPTQ.
2.2. GGUF, AWQ và GPTQ nằm ở những tầng khác nhau
Đặc tả GGUF của ggml mô tả container lưu metadata và tensor. GGUF có thể chứa nhiều kiểu tensor; đuôi .gguf không có nghĩa mọi trọng số là 4-bit. Tokenizer, kiến trúc và thông tin tensor phải được runtime hiểu. Một file hợp lệ theo cấu trúc vẫn có thể chứa kiến trúc hoặc kiểu lượng tử mà bản runtime cụ thể chưa hỗ trợ.
Trong llama.cpp, Q4_K_M là tên một cấu hình lượng tử hóa và lựa chọn kiểu cho các tensor, không phải cam kết đúng 4 bit cho mọi tham số. Scale, thông tin block và các tensor có precision khác làm số bit trung bình tăng. Hướng dẫn llama-quantize cũng cung cấp cách dùng importance matrix; vì vậy không nên đồng nhất mọi GGUF quant với “làm tròn mù, không dùng dữ liệu”.
AWQ — Lin và cộng sự dùng thống kê activation để nhận diện kênh trọng số quan trọng, rồi tìm scale bảo vệ các kênh đó khi lượng tử hóa. Với quy ước Y = WX, một biến đổi tương đương là Y = (WS)(S⁻¹X) khi S là ma trận đường chéo khả nghịch. Trước lượng tử hóa, hai biểu thức bằng nhau; sau làm tròn WS, sai số đổi. Ý tưởng không phải giữ cố định một phần trọng số ở FP16: scaling giúp tránh yêu cầu mixed precision không thuận lợi cho phần cứng. AWQ là phương pháp weight-only; tên “activation-aware” không có nghĩa activation cũng bị nén xuống 4-bit. Kernel packing và fusion của TinyChat là phần hệ thống giúp biến giảm storage thành tăng tốc; không thể chuyển số đo của paper thành bảo đảm cho thiết bị khác.
GPTQ — Frantar và cộng sự xấp xỉ bài toán giảm ||WX − W_hat X||² từng lớp, với X lấy từ dữ liệu calibration. Phương pháp dùng thông tin bậc hai, liên quan tới XXᵀ, lượng tử hóa theo cột/block và điều chỉnh trọng số chưa lượng tử để bù sai số. Damping hỗ trợ tính ổn định của phép phân rã; dữ liệu calibration và cấu hình nhóm ảnh hưởng artifact thu được. Đây là post-training quantization, không phải huấn luyện lại toàn bộ model bằng gradient. Các biến thể và kernel hiện thực khác nhau phải được ghi rõ; chỉ nhãn “GPTQ 4-bit” chưa đủ tái lập kết quả.
AWQ/GPTQ đều cần kiểm tra dữ liệu calibration đại diện: văn bản Nhật–Việt, thuật ngữ nhà máy, độ dài đầu vào và chat template. Không dùng bộ nghiệm thu làm dữ liệu chỉnh cấu hình rồi báo điểm trên chính bộ đó. Đổi đuôi file hay repack giữa hai runtime không tái tạo thuật toán calibration; xuất sang kiểu khác cần kiểm thử lại artifact cuối.
2.3. Theo dấu một request và ngân sách bộ nhớ
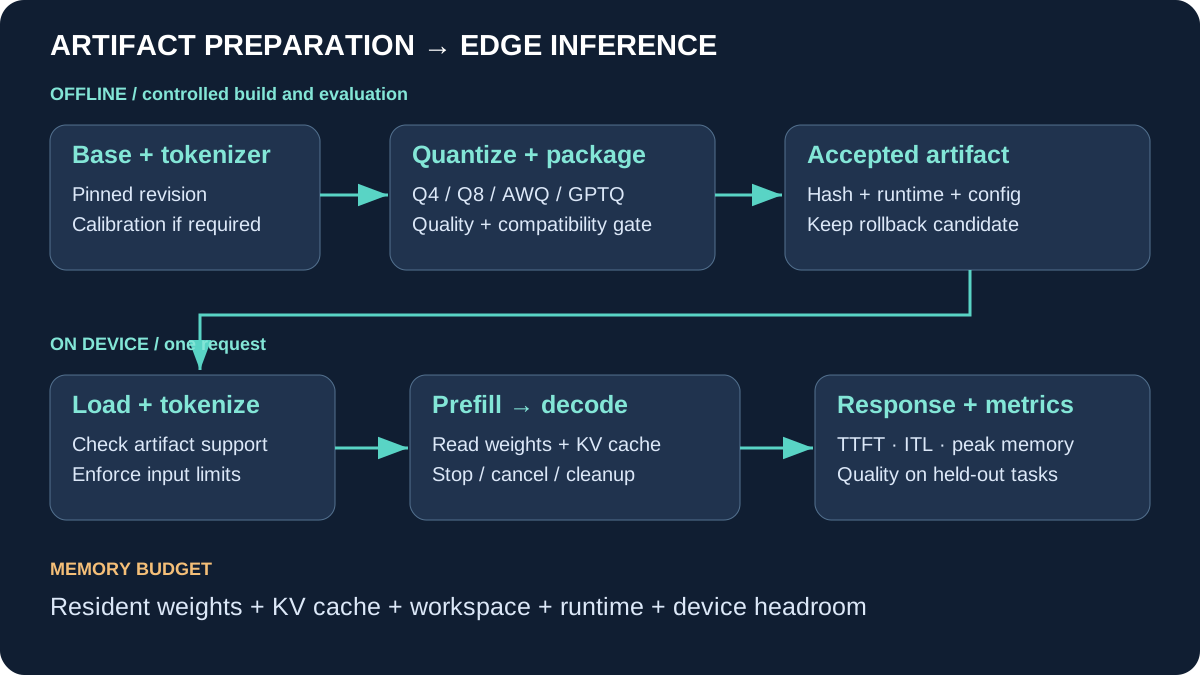
Sơ đồ SVG do bài tự vẽ, cho phép sử dụng theo CC0 1.0. Đây là luồng khái niệm, không biểu diễn số đo. Nhánh offline lấy base cùng tokenizer/config cố định, tạo candidate rồi kiểm tra chất lượng và tương thích. Nhánh thiết bị chỉ nạp artifact được chấp nhận. Một request được token hóa, chạy prefill để tạo KV, rồi decode từng token; mỗi bước decode đọc trọng số và KV đã tích lũy. Khi đủ token, gặp stop condition hoặc hủy yêu cầu, runtime phải thu hồi tài nguyên phiên theo thiết kế của nó. Artifact không hỗ trợ phải bị chặn trước phục vụ; lỗi hết bộ nhớ cần ghi cấu hình và dừng phiên có kiểm soát, không retry vô hạn cùng tải.
Ước lượng payload trọng số là P × b/8 byte với P tham số và b bit. Model giả định 7 tỷ tham số có payload FP16 khoảng 14 GB, 8-bit 7 GB và 4-bit 3,5 GB (GB thập phân). Đây là phép tính lý tưởng; chưa có scale, alignment, tensor không nén hoặc runtime. Không dùng nó làm dự báo RAM đỉnh.
Với attention thông thường hoặc GQA, KV cache không chia sẻ giữa các phiên và cùng độ dài T, ước lượng payload:
M_KV = 2 × L × B × T × H_kv × D_head × bytes_per_element.
Hệ số 2 là K và V; L là số layer, B số phiên, H_kv số KV head, D_head kích thước head. Ví dụ tự đặt L=32, B=1, T=4096, H_kv=8, D_head=128, dtype=2 byte cho 512 MiB. Tăng T gấp đôi làm phần này gấp đôi nếu các yếu tố khác giữ nguyên. MHA phải dùng số KV head thực; kiến trúc có cache nén, sliding attention hoặc cơ chế khác cần công thức tương ứng. Phân bổ cache theo trang, phần dự phòng và padding còn làm số đo khác payload.
Ngân sách đỉnh cần xét trọng số resident, KV, activation/workspace, runtime và phần OS/ứng dụng khác. Trên máy unified memory, tránh cộng hai lần cùng trang được CPU/GPU chia sẻ; trên GPU rời, tính riêng host RAM, VRAM và chi phí truyền. Trong decode batch nhỏ, giảm byte đọc có thể giúp khi memory bandwidth là nút thắt. Prefill dài có thể nghiêng về compute; unpack/dequantization, kernel fallback, offload và nhiệt độ có thể xóa lợi ích. Đó là lý do phải đo prefill và decode riêng.
量子化によって、重みのメモリ使用量を減らします。ただし、KVキャッシュの容量は別に確認する必要があります。4ビットにすれば、必ず速くなるとは限りません。同じ条件で品質と遅延を比較した上で、採用を判断します。
Dịch: Lượng tử hóa giúp giảm bộ nhớ dùng cho trọng số. Tuy nhiên, cần kiểm tra dung lượng KV cache riêng. Chuyển sang 4-bit không nhất thiết làm hệ thống nhanh hơn. Chúng tôi sẽ quyết định áp dụng sau khi so sánh chất lượng và độ trễ trong cùng điều kiện.
Phân tích câu: 〜によって chỉ phương thức tạo ra thay đổi; chủ thể đang giảm là bộ nhớ trọng số. ただし bổ sung giới hạn KV, tránh người nghe hiểu là giảm toàn bộ RAM. 〜とは限りません bác tính tất yếu, không khẳng định 4-bit luôn chậm. 比較した上で đặt việc so sánh thành bước phải hoàn tất trước quyết định, còn 同じ条件で giới hạn phạm vi kết luận.
3. Hiện thực hóa kỹ thuật — 実装する
3.1. Môi trường và cách chạy
Ví dụ chính là một file quant_demo.py, dùng Python 3.10+ và thư viện chuẩn math, không tải model hoặc cài dependency. Chép toàn bộ code mục 3.3 vào file rồi chạy python3 quant_demo.py. Kết quả in sai số trọng số, sai số output lớp tuyến tính trên vector tự tạo, cùng số byte giả định nếu đóng gói trọng số và lưu một scale FP32 mỗi nhóm.
Không đo thời gian vòng lặp Python để suy ra tốc độ kernel LLM. Danh sách int của Python vẫn là object tốn bộ nhớ; số byte in ra là ước lượng encoding, không phải RSS của chương trình. Đây là lựa chọn có chủ đích để minh bạch phép toán.
3.2. Cách triển khai ban đầu
Cách đơn giản dùng scale cho toàn bộ hàng: chia giá trị lớn nhất cho 7 hoặc 127, làm tròn rồi nhân scale trở lại. Nó đủ cho một baseline quan sát được. Với hàng [0.1, 0.2, -0.3, 7.0], outlier 7 kéo lưới 4-bit giãn tới bước 1; ba giá trị nhỏ đều bị làm tròn về 0. Hạn chế xuất hiện khi một nhóm có dynamic range lớn, không có nghĩa mọi hàng đều cần phương pháp phức tạp.
Cải tiến minh họa chia hàng thành nhóm 2 để hai giá trị đầu có scale riêng, giữ nhóm cuối chứa outlier. Đây là group-wise round-to-nearest, không thay thế AWQ/GPTQ. Ta so cùng input, báo cả weight MSE và output error vì chúng trả lời hai câu hỏi khác nhau.
3.3. Cách triển khai cải tiến
from math import isfinite, ceil


def quantize(values: list[float], bits: int, group_size: int
             ) -> tuple[list[int], list[float], list[float]]:
    if bits not in (4, 8):
        raise ValueError("bits must be 4 or 8")
    if type(group_size) is not int or group_size <= 0:
        raise ValueError("group_size must be a positive integer")
    if not values or any(not isfinite(v) for v in values):
        raise ValueError("values must be nonempty and finite")
    qmax = (1 << (bits - 1)) - 1
    codes: list[int] = []
    scales: list[float] = []
    restored: list[float] = []
    for start in range(0, len(values), group_size):
        block = values[start:start + group_size]
        peak = max(abs(v) for v in block)
        scale = peak / qmax if peak else 1.0
        if scale == 0.0:  # Extremely small subnormal inputs.
            raise ValueError("scale underflow")
        q = [max(-qmax, min(qmax, round(v / scale))) for v in block]
        codes.extend(q)
        scales.append(scale)
        restored.extend(v * scale for v in q)
    return codes, scales, restored


def mse(a: list[float], b: list[float]) -> float:
    if not a or len(a) != len(b):
        raise ValueError("MSE requires equal nonempty vectors")
    return sum((x - y) ** 2 for x, y in zip(a, b)) / len(a)


def dot(a: list[float], b: list[float]) -> float:
    if not a or len(a) != len(b):
        raise ValueError("dot requires equal nonempty vectors")
    return sum(x * y for x, y in zip(a, b))


def main() -> None:
    weights = [0.1, 0.2, -0.3, 7.0, 0.05, -0.08, 0.13, -0.2]
    activation = [1.0, 2.0, 0.5, -0.2, 3.0, 0.1, -1.0, 0.4]
    for bits, group in [(4, 8), (4, 2), (8, 8)]:
        codes, scales, restored = quantize(weights, bits, group)
        packed_bytes = ceil(len(codes) * bits / 8) + 4 * len(scales)
        output_error = abs(dot(weights, activation) - dot(restored, activation))
        print(f"W{bits} g={group}: weight_mse={mse(weights, restored):.6f} "
              f"output_abs_error={output_error:.6f} bytes_est={packed_bytes}")
    assert quantize([0.0, 0.0, 0.0], 4, 2)[2] == [0.0, 0.0, 0.0]
    assert quantize([-7.0, 0.0, 7.0], 4, 3)[2] == [-7.0, 0.0, 7.0]
    codes, scales, restored = quantize([0.1, 0.2, 0.3], 8, 2)
    assert len(codes) == len(restored) == 3 and len(scales) == 2
    for values, bits, group in [([], 4, 2), ([float("nan")], 4, 2),
                                ([float("inf")], 4, 2), ([1.0], 3, 2),
                                ([1.0], 4, 0), ([5e-324], 8, 1)]:
        try:
            quantize(values, bits, group)
        except ValueError:
            pass
        else:
            raise AssertionError("invalid input was accepted")
    print("zero, endpoints, partial group and invalid-input checks: PASS")


if __name__ == "__main__":
    main()
round() dùng quy tắc tie-to-even của Python; các kernel khác có thể làm tròn khác. Nhóm toàn zero dùng scale 1 để tránh chia cho 0. Nhóm cuối không đủ kích thước vẫn được xử lý; dữ liệu rỗng, NaN/Infinity, bit-width không hỗ trợ và scale underflow bị từ chối. Metadata giả định chưa có alignment và zero-point; scale thực trong ví dụ là Python float, chưa ép FP32. Với dữ liệu cực lớn, phép bình phương trong MSE cũng có thể tràn: chương trình chỉ dành cho tensor nhỏ tự tạo như trên.
Ví dụ không có network, concurrency hoặc retry; thêm chúng ở đây không giúp kiểm chứng quantization. Với pipeline artifact thật, mỗi lần quantize phải ghi output mới, xác minh checksum và thoát lỗi rõ ràng. Với serving, đặt timeout/hủy phiên theo runtime, giới hạn context/phiên đồng thời và chỉ retry lỗi có khả năng phục hồi; không tự lặp khi model không tương thích hoặc hết tài nguyên với cùng input.
3.4. Cách kiểm chứng và thử artifact thật
Kiểm chứng local đã chạy: script cho weight_mse lần lượt 0.025725, 0.011298, 0.000322; output_abs_error là 0.282000, 0.138571, 0.092803 cho W4/g8, W4/g2, W8/g8. Ước lượng encoding tương ứng 8, 20, 12 byte. Các ca zero, hai đầu mút, nhóm cuối và sáu đầu vào lỗi đều đạt. Với vector rất nhỏ này, metadata nhóm 2 làm encoding W4 lớn hơn W8/g8, minh họa vì sao chỉ đếm bit chưa đủ. Các kết quả chỉ mô tả vector minh họa; giảm MSE ở đây chưa chứng minh câu trả lời LLM tốt hơn. Không có model/GPU benchmark trong lượt biên soạn này.
Quy trình llama.cpp cần thiết bị và model riêng: chuẩn bị một base GGUF precision cao được tạo từ đúng revision và tokenizer; lưu hash, license và cấu hình. Ghi commit runtime và tùy chọn build. Kiểm tra --help của binary đã build vì CLI thay đổi theo revision. Theo tài liệu quantize, mẫu lệnh cho hai candidate là:
./build/bin/llama-quantize base-f16.gguf candidate-q4.gguf Q4_K_M
./build/bin/llama-quantize base-f16.gguf candidate-q8.gguf Q8_0
base-f16.gguf là file local bạn đã chuẩn bị; không phải URL hay model kèm bài. Không lấy bản 4-bit làm đầu vào để “nâng lại” thành 8-bit: thông tin đã mất không tự trở lại. Quantize cần tài nguyên riêng; model vừa khi inference không chứng minh máy có đủ RAM khi chuyển đổi.
llama-bench phân biệt prompt processing và generation. Ví dụ CPU cố định 4 thread, 512 token prompt, 128 token generation, 5 lần lặp:
./build/bin/llama-bench -m candidate-q4.gguf -p 512 -n 128 -r 5 -t 4 -ngl 0 -o json
./build/bin/llama-bench -m candidate-q8.gguf -p 512 -n 128 -r 5 -t 4 -ngl 0 -o json
Đây là hướng dẫn chưa chạy, cần binary hỗ trợ các cờ tương ứng. Các giá trị là cấu hình minh họa, không phải SLO. Khi thử GPU, đổi offload cho cả hai một cách có kiểm soát và ghi phần nào thực sự chạy trên GPU. Benchmark kernel không gồm mọi chi phí request như tokenization/sampling; bổ sung phép đo ứng dụng từ lúc nhận yêu cầu tới token đầu, rồi timestamp từng token để tính ITL/p95. Chạy warm-up riêng, báo cold start riêng, giữ chế độ điện/nhiệt độ ổn định, ghi peak RAM/VRAM và lặp đủ để thấy dao động.
Bộ nghiệm thu nên có câu hỏi tiếng Nhật và tiếng Việt, phủ định, đơn vị đo, mã thiết bị, JSON/schema và context gần giới hạn đã chốt. Giữ input/template/tokenizer, decoding và seed giống nhau khi được hỗ trợ; không hứa output bitwise giống giữa backend. Dùng baseline precision cao làm mốc, nhưng chấm theo đáp án/rubric độc lập thay vì coi mọi câu baseline là đúng. Nếu không chạy được baseline trên thiết bị đích, đo chất lượng ở máy đủ tài nguyên và ghi rõ không có so sánh latency FP16 cùng máy.
Ví dụ tiêu chí đề xuất để thương lượng, chưa phải kết quả: giảm điểm nghiệp vụ không quá 1 điểm phần trăm so baseline trên tập đã khóa, không có hồi quy ở ca trọng yếu, peak trong ngân sách đã dành cho ứng dụng, TTFT/ITL đạt SLO được ký duyệt. Với tập nhỏ, báo cả số câu sai và khoảng bất định; “không phát hiện hồi quy” không đồng nghĩa “không có hồi quy”. Chỉ ký nhận đúng hash artifact được đo, giữ baseline để rollback.
4. Cạm bẫy thực tế và đánh đổi — 注意点とトレードオフ
4.1. File vừa ổ đĩa nhưng request dài bị OOM
Triệu chứng: load thành công, lỗi khi tăng context hoặc số phiên. Nguyên nhân: chỉ tính trọng số, bỏ KV/workspace và ứng dụng cùng máy. Phát hiện: ghi peak từng pha load/prefill/decode, thử biên input và concurrency đã chốt. Khắc phục: dành headroom từ số đo, giới hạn context/phiên, hoặc chọn model nhỏ hơn; chỉ thử KV quantization khi runtime hỗ trợ và đã kiểm chất lượng riêng. Đánh đổi: context ngắn có thể mất chứng cứ; ít phiên tạo hàng đợi; nén KV thêm nguồn sai số.
4.2. 4-bit chậm hơn 8-bit
Triệu chứng: file nhỏ hơn nhưng TTFT hoặc decode xấu hơn. Nguyên nhân: kernel không tối ưu, dequantization tốn thời gian, offload qua bus, prefill compute-bound hoặc throttling. Phát hiện: đối chiếu log backend, placement, profiler và số đo prefill/decode riêng sau warm-up. Khắc phục: chọn dtype/kernel được tăng tốc trên thiết bị hoặc đổi cách offload, đo lại ứng dụng. Đánh đổi: tăng precision tốn bộ nhớ; tối ưu riêng backend làm pipeline khó mang sang thiết bị khác. Cùng “4-bit” nhưng packing khác không phải cùng workload máy.
4.3. Điểm trung bình ổn nhưng thuật ngữ Nhật hoặc số liệu sai
Triệu chứng: câu trả lời trôi chảy, song sai phủ định, đơn vị hoặc mã sản phẩm. Nguyên nhân có thể: sai số lượng tử, calibration không đại diện, hoặc template/tokenizer thay đổi ngoài ý muốn. Phát hiện: dùng paired test, chia nhóm ngôn ngữ/loại nhiệm vụ và so manifest trước khi quy lỗi cho quantizer. Khắc phục: điều chỉnh calibration, tăng bit cho candidate hoặc dùng model khác, giữ tập test độc lập. Đánh đổi: tốn vòng thử và storage; không thể bảo đảm bảo toàn mọi năng lực chỉ từ một perplexity score.
4.4. Artifact hợp lệ nhưng runtime không nạp được
Triệu chứng: unsupported tensor type, sai shape hoặc output vô nghĩa ngay từ đầu. Nguyên nhân: thiếu hỗ trợ kiến trúc, tensor packing hoặc chat template không khớp. Phát hiện: smoke test load/tokenize/generate theo revision đã khóa và kiểm hash sau copy. Khắc phục: dùng cặp exporter/runtime được kiểm chứng, đóng gói config cùng artifact, rollback cả bộ. Đánh đổi: thêm ma trận tương thích và lưu trữ; nâng runtime để sửa load vẫn cần regression test, không mặc nhiên giữ chất lượng.
| Phương án | Bộ nhớ/chi phí | Hiệu năng cần đo | Độ phức tạp vận hành | Tin cậy và điều kiện chọn |
|---|---|---|---|---|
| FP16/BF16 baseline | Trọng số lớn; cần máy đủ tài nguyên | Mốc tham chiếu, không mặc định chậm nhất | Ít bước quantize, vẫn cần đúng tokenizer/runtime | Dùng làm đối chứng chất lượng khi đủ tài nguyên |
| GGUF Q8_0 + runtime hỗ trợ | Payload thấp hơn FP16, thêm metadata | Kernel và placement quyết định | Giữ manifest kiểu tensor và runtime | Ứng viên khi Q4 không đạt chất lượng mà Q8 vừa ngân sách |
| GGUF Q4_K_M + runtime hỗ trợ | Giảm storage mạnh; không đúng 4 bit mọi tensor | Đo cả CPU/GPU và context thực | Chốt cấu hình tensor, không suy từ đuôi file | Ứng viên cho thiết bị hạn chế, phải vượt cổng hồi quy |
| AWQ weight-only 4-bit | Thêm chi phí calibration/export | Cần packing và kernel phù hợp | Quản lý dữ liệu calibration, scale, exporter và runtime | Thử khi stack đích có hỗ trợ; so chất lượng trên nghiệp vụ |
| GPTQ weight-only 4-bit | Thêm chi phí calibration/tính toán offline | Tùy kernel/nhóm/placement | Ghi cấu hình nhóm, calibration và biến thể | Thử khi hệ sinh thái đích phù hợp, đánh giá artifact cuối |
Bảng là so sánh định tính giữa các tổ hợp triển khai, không xếp GGUF ngang hàng thuật toán. Điểm bắt đầu của dự án giả định là hai candidate Q4/Q8 từ cùng base trên runtime hỗ trợ thiết bị. Chỉ mở rộng sang AWQ/GPTQ khi chúng tương thích và có lý do thử nghiệm cụ thể; không đổi cả runtime, model và bit-width trong một phép đo rồi quy toàn bộ chênh lệch cho bit-width.
5. Checklist trước khi triển khai — 本番への適用前チェック
- Khóa hash base, tokenizer/template, artifact cuối, revision runtime và quyền sử dụng model; lưu cấu hình quantization/calibration.
- Có kết quả chất lượng trên tập Nhật–Việt độc lập, gồm phủ định, đơn vị, mã thiết bị và ca trọng yếu; ngưỡng hồi quy đã được thống nhất.
- Đo peak RAM/VRAM với context và concurrency lớn nhất cho phép, kể cả ứng dụng khác cùng máy; ghi giới hạn đầu vào và headroom.
- Đo riêng cold start, TTFT, ITL và throughput sau warm-up; lưu backend/offload/thread count, chế độ điện và nhiệt độ.
- Kiểm tra file không hỗ trợ, checksum sai, OOM, timeout và hủy request; không retry vô hạn hoặc ghi tài liệu nhạy cảm vào log.
- Diễn tập rollback bằng đúng artifact/tokenizer/runtime đã nghiệm thu; xác nhận thời gian phục hồi và người chịu trách nhiệm.
- Chốt chi phí thiết bị, điện năng, lưu trữ/cập nhật model và tiêu chí nghiệm thu với khách hàng; giữ bằng chứng theo từng artifact.
6. Học tiếng Nhật qua chủ đề — 技術日本語を学ぶ
6.1. Sổ tay thuật ngữ kỹ thuật và giao tiếp BrSE
Các câu dưới đây là ví dụ tự soạn. Cột Hán Việt giúp nhớ chữ, không phải bản dịch máy của thuật ngữ. 精度 trong trao đổi AI thường nói độ chính xác; khi nói numeric precision cần chỉ rõ bit-width/dtype để tránh nhập nhằng với task accuracy.
| Thuật ngữ Nhật | Furigana | Hán Việt | Nghĩa tiếng Việt / English | Câu ví dụ Nhật | Dịch nghĩa |
|---|---|---|---|---|---|
| 量子化 | りょうしか | Lượng tử hóa | Lượng tử hóa / Quantization | 量子化の条件を記録します。 | Ghi lại điều kiện lượng tử hóa. |
| 重み | おもみ | Trọng | Trọng số / Weight | 重みを4ビットで保存します。 | Lưu trọng số ở 4-bit. |
| 精度 | せいど | Tinh độ | Độ chính xác / Accuracy | 精度だけでなく、遅延も評価します。 | Đánh giá độ trễ bên cạnh độ chính xác. |
| 誤差 | ごさ | Ngộ sai | Sai số / Error | 誤差が出力に与える影響を調べます。 | Kiểm tra ảnh hưởng của sai số lên output. |
| 推論 | すいろん | Suy luận | Chạy suy luận / Inference | 推論は端末で実行します。 | Inference chạy trên thiết bị. |
| 評価 | ひょうか | Bình giá | Đánh giá / Evaluation | 評価データを分けます。 | Tách riêng dữ liệu đánh giá. |
| 遅延 | ちえん | Trì diên | Độ trễ / Latency | 遅延を同じ条件で測定します。 | Đo độ trễ trong cùng điều kiện. |
| 比較 | ひかく | Tỉ giảo | So sánh / Comparison | 4ビットと8ビットを比較します。 | So sánh 4-bit và 8-bit. |
| 検証 | けんしょう | Kiểm chứng | Kiểm chứng / Verification | 実機で検証します。 | Kiểm chứng trên máy thật. |
| 条件 | じょうけん | Điều kiện | Điều kiện / Condition | 条件に応じてモデルを選びます。 | Chọn mô hình tùy điều kiện. |
| 容量 | ようりょう | Dung lượng | Dung lượng / Capacity | KVキャッシュの容量も必要です。 | Cũng cần dung lượng cho KV cache. |
| 保証 | ほしょう | Bảo chứng | Bảo đảm / Guarantee | 速度はまだ保証できません。 | Chưa thể bảo đảm tốc độ. |
確認 là xác nhận một dữ kiện hoặc cách hiểu; 検証 nhấn mạnh kiểm chứng bằng phép thử/bằng chứng. Trong cuộc họp, hỏi “context tối đa đã thống nhất chưa” là xác nhận; chạy tải ở context đó và đối chiếu peak là kiểm chứng. 誤差 là sai lệch số học, không đồng nghĩa 不具合 — lỗi chức năng; sai số nhỏ vẫn có thể dẫn tới token khác.
Thuật ngữ bổ sung để đọc hội thoại
Bảng bổ sung cung cấp từ tra cứu cho các Kanji xuất hiện trong câu, không thay thế 12 thuật ngữ trọng tâm phía trên.
| Thuật ngữ Nhật | Furigana | Hán Việt | Nghĩa tiếng Việt / English | Câu ví dụ Nhật | Dịch nghĩa |
|---|---|---|---|---|---|
| 与える | あたえる | Dữ | Gây ra, mang lại / Give | 誤差が出力に影響を与えます。 | Sai số gây ảnh hưởng lên output. |
| 両立 | りょうりつ | Lưỡng lập | Đáp ứng đồng thời / Compatibility | 品質と速度の両立を目指します。 | Hướng tới đáp ứng cả chất lượng lẫn tốc độ. |
| 平均 | へいきん | Bình quân | Trung bình / Average | 平均だけでは判断できません。 | Không thể quyết định chỉ bằng số trung bình. |
| 小さい | ちいさい | Tiểu | Nhỏ / Small | ファイルが小さくなります。 | File trở nên nhỏ hơn. |
| 必ず | かならず | Tất | Nhất định, luôn luôn / Always | 必ず速くなるとは限りません。 | Không nhất thiết luôn nhanh hơn. |
| 判断 | はんだん | Phán đoán | Phán đoán, quyết định / Judgment | 結果に応じて判断します。 | Quyết định tùy kết quả. |
| 最大 | さいだい | Tối đại | Lớn nhất / Maximum | 最大入力で検証します。 | Kiểm chứng với input lớn nhất. |
| 端末 | たんまつ | Đoan mạt | Thiết bị đầu cuối / Terminal | 端末で推論します。 | Chạy inference trên thiết bị đầu cuối. |
| 私 | わたし | Tư | Tôi / I | 私が結果を報告します。 | Tôi sẽ báo cáo kết quả. |
| 技術 | ぎじゅつ | Kỹ thuật | Kỹ thuật / Technology | 技術の条件を確認します。 | Xác nhận các điều kiện kỹ thuật. |
| 記録 | きろく | Ký lục | Ghi lại / Record | 測定条件を記録します。 | Ghi lại điều kiện đo. |
| 日本語 | にほんご | Nhật bản ngữ | Tiếng Nhật / Japanese | 日本語の品質も評価します。 | Cũng đánh giá chất lượng tiếng Nhật. |
| 足りる | たりる | Túc | Đủ / Suffice | メモリが足りるか確認します。 | Kiểm tra bộ nhớ có đủ không. |
| 速度 | そくど | Tốc độ | Tốc độ / Speed | 速度を実機で測定します。 | Đo tốc độ trên máy thật. |
| 選ぶ | えらぶ | Tuyển | Chọn / Choose | 条件に応じて選びます。 | Chọn tùy điều kiện. |
| 願う | ねがう | Nguyện | Mong, đề nghị / Wish | ご確認をお願いします。 | Nhờ anh/chị xác nhận. |
| 実機 | じっき | Thực cơ | Máy thật / Actual device | 実機の容量を確認します。 | Xác nhận dung lượng của máy thật. |
Tra Kanji trong bài (122 chữ)
上 · 下 · 不 · 与 · 両 · 仕 · 件 · 伝 · 使 · 価 · 保 · 候 · 先 · 入 · 具 · 出 · 分 · 判 · 別 · 前 · 力 · 化 · 合 · 同 · 告 · 品 · 回 · 均 · 基 · 報 · 場 · 増 · 変 · 大 · 子 · 存 · 学 · 定 · 実 · 容 · 対 · 小 · 差 · 平 · 度 · 延 · 影 · 必 · 応 · 意 · 技 · 持 · 指 · 採 · 推 · 提 · 数 · 断 · 方 · 日 · 時 · 更 · 最 · 未 · 末 · 本 · 条 · 果 · 検 · 機 · 比 · 注 · 減 · 測 · 準 · 点 · 現 · 理 · 用 · 番 · 発 · 目 · 確 · 私 · 立 · 端 · 答 · 精 · 組 · 結 · 維 · 行 · 術 · 装 · 補 · 要 · 解 · 記 · 証 · 評 · 認 · 語 · 誤 · 調 · 論 · 質 · 足 · 較 · 速 · 遅 · 違 · 適 · 選 · 重 · 量 · 針 · 録 · 長 · 開 · 限 · 響 · 願
6.2. Ngữ pháp và mẫu diễn đạt
| Mẫu | Ý nghĩa | Ví dụ |
|---|---|---|
| 〜に応じて | Tùy theo điều kiện mà điều chỉnh | 条件に応じてビット数を選びます。 — Chọn số bit tùy điều kiện. |
| 〜とは限らない | Không nhất thiết; tránh khẳng định tuyệt đối | 4ビットのほうが速いとは限りません。 — 4-bit không nhất thiết nhanh hơn. |
| 〜た上で | Sau khi đã làm bước nền tảng | 検証した上で判断します。 — Quyết định sau khi kiểm chứng. |
-
〜に応じて: Chọn cấu hình theo ràng buộc thay đổi.
- Cấu trúc: N + に応じて + hành động điều chỉnh.
- Sắc thái: Hai yếu tố có quan hệ thích ứng, không chỉ nối hai sự kiện ngẫu nhiên. Hữu ích khi giải thích khác biệt cấu hình theo thiết bị.
- Ví dụ 1: 端末の容量に応じてモデルを選びます。 — Chọn mô hình tùy dung lượng thiết bị.
- Ví dụ 2: 評価結果に応じてビット数を変更します。 — Điều chỉnh số bit theo kết quả đánh giá.
- Lỗi thường gặp: Viết
条件によって違いますchỉ nói có khác biệt, chưa chỉ rõ ai sẽ điều chỉnh gì. Khi đề xuất, nêu luôn hành động và tiêu chí.
-
〜とは限らない: Bác bỏ một kết luận mang tính tất yếu.
- Cấu trúc: Mệnh đề thể thông thường + とは限らない; dạng lịch sự là とは限りません.
- Sắc thái: Thừa nhận khả năng có ngoại lệ; phù hợp khi khách hàng suy từ file nhỏ sang nhanh hơn. Không phải lời phủ định toàn bộ phương án.
- Ví dụ 1: 容量が小さければ、遅延も小さくなるとは限りません。 — Dung lượng nhỏ hơn không nhất thiết khiến độ trễ giảm.
- Ví dụ 2: 平均精度が同じでも、品質が同じとは限りません。 — Dù độ chính xác trung bình bằng nhau, chất lượng chưa chắc giống nhau.
- Lỗi thường gặp: Chỉ nói “chưa chắc” rồi kết thúc khiến đề xuất thiếu hướng xử lý. Nối với phép đo và mốc trả lời cụ thể.
-
〜た上で: Hoàn tất kiểm tra rồi mới đưa ra quyết định.
- Cấu trúc: V thể た + 上で + quyết định/hành động tiếp theo.
- Sắc thái: Bước trước là cơ sở cần thiết của bước sau, mạnh hơn việc đơn thuần kể thứ tự. Dùng khi thống nhất cổng nghiệm thu.
- Ví dụ 1: 実機で測定した上で、採用を判断します。 — Quyết định áp dụng sau khi đo trên máy thật.
- Ví dụ 2: 品質を確認した上で、結果をご報告します。 — Báo cáo kết quả sau khi kiểm tra chất lượng.
- Lỗi thường gặp:
確認する上でthường mang nghĩa “trong việc kiểm tra”, không cùng nghĩa “sau khi đã kiểm tra”. Chọn thể た khi bước trước phải hoàn tất.
6.3. Luyện tập ngắn
- Điền mẫu phù hợp: 端末の容量( )、モデルを選びます。 Mục tiêu là nói cấu hình thích ứng với dung lượng.
- Dịch Việt → Nhật: “Chúng tôi sẽ quyết định áp dụng sau khi so sánh chất lượng và độ trễ trên máy thật.”
- Sửa phát biểu quá chắc chắn 4ビットなら、必ず速くなります。 để thể hiện chưa đo và nêu bước tiếp theo.
Đáp án và giải thích:
に応じて: 端末の容量に応じて、モデルを選びます。 — Chọn mô hình tùy dung lượng thiết bị. Danh từ đứng trước に応じて, hành động điều chỉnh đứng sau.- 実機で品質と遅延を比較した上で、採用を判断します。 — Quyết định áp dụng sau khi so sánh chất lượng và độ trễ trên máy thật. Câu giữ cả phạm vi đo lẫn thứ tự quyết định.
- 4ビットにすれば、必ず速くなるとは限りません。速度はまだ測定していないため、実機で検証します。 — 4-bit không nhất thiết nhanh hơn. Vì chưa đo tốc độ, chúng tôi sẽ kiểm chứng trên máy thật. Nêu rõ thiếu bằng chứng nào, không chỉ thêm từ giảm mức chắc chắn.
7. Thực hành vai trò BrSE — 現場で伝える
7.1. Tình huống giao tiếp
Vai trò: KH là phụ trách sản phẩm phía Nhật; BrSE điều phối đội phát triển. Mục tiêu: thống nhất phép thử Q4/Q8 trước quyết định triển khai. Dữ kiện giả định đã xác nhận trong tình huống: yêu cầu offline, có thể chuẩn bị hai candidate từ cùng base. Chưa rõ: peak và chất lượng/latency trên thiết bị đích. Cuộc hội thoại không đại diện cho kết quả dự án thật.
- KH: オフラインで使うことが前提です。4ビットで対応できますか。
Việt: Điều kiện tiên quyết là dùng offline. Có thể đáp ứng bằng 4-bit không? - BrSE: オフラインでの推論が必要という理解でよろしいでしょうか。品質と遅延の条件も確認させてください。
Việt: Tôi hiểu rằng cần inference offline, đúng không ạ? Xin xác nhận thêm điều kiện chất lượng và độ trễ. - KH: 日本語の回答品質を維持したいです。速度も重要です。
Việt: Chúng tôi muốn giữ chất lượng trả lời tiếng Nhật. Tốc độ cũng quan trọng. - BrSE: 同じモデルから4ビットと8ビットの候補を用意します。ただし、容量が小さくても、必ず速いとは限りません。
Việt: Chúng tôi sẽ chuẩn bị hai candidate 4-bit và 8-bit từ cùng model. Dung lượng nhỏ hơn vẫn chưa chắc nhanh hơn. - KH: 長い入力でも、メモリは足りますか。
Việt: Với input dài thì bộ nhớ có đủ không? - BrSE: KVキャッシュの使用量も増えるため、最大の入力条件で検証します。現時点では保証できません。
Việt: KV cache cũng tăng nên chúng tôi sẽ kiểm chứng ở điều kiện input lớn nhất. Hiện chưa thể bảo đảm. - KH: 4ビットで品質が下がった場合はどうしますか。
Việt: Nếu chất lượng giảm với 4-bit thì xử lý thế nào? - BrSE: 8ビットの候補も評価します。容量は増えますが、結果を比較した上で判断します。
Việt: Chúng tôi cũng đánh giá candidate 8-bit. Dung lượng sẽ tăng, nhưng sẽ so kết quả rồi mới quyết định. - KH: では、評価条件を先に合意しましょう。報告はいつできますか。
Việt: Vậy hãy thống nhất điều kiện đánh giá trước. Khi nào có thể báo cáo? - BrSE: 開発チームが実機で測定し、私が【報告日】までに結果と未確認の点をご報告します。評価条件は【合意日】までに確認させてください。
Việt: Đội phát triển sẽ đo trên máy thật; tôi báo cáo kết quả và điểm chưa xác minh trước ngày báo cáo. Xin xác nhận điều kiện đánh giá trước ngày thống nhất.
Hai placeholder ngày phải được thay bằng lịch đã thống nhất, gồm múi giờ nếu hai nhóm khác nước. Lượt 6 nêu rõ giới hạn bằng chứng; lượt 8 đưa phương án dự phòng cùng chi phí; lượt 10 chốt người thực hiện, người báo cáo và hai mốc phụ thuộc nhau.
7.2. Mẫu thông điệp dùng ngay
本日は、4ビットと8ビットの候補を比較する方針で合意しました。最大入力と品質の基準は、まだ未確認です。【合意日】までにご確認をお願いします。開発チームが実機で測定した上で、BrSEが【報告日】までに結果をご報告します。採用は評価結果に応じて判断します。
Dịch: Hôm nay đã thống nhất hướng so sánh candidate 4-bit và 8-bit. Input tối đa và tiêu chuẩn chất lượng còn chưa xác nhận; nhờ xác nhận trước 【ngày thống nhất】. Sau khi đội phát triển đo trên máy thật, BrSE sẽ báo cáo kết quả trước 【ngày báo cáo】. Quyết định áp dụng dựa vào kết quả đánh giá.
方針で合意しました giới hạn thỏa thuận ở phương hướng thử, không tuyên bố đã nghiệm thu. まだ未確認です nêu trạng thái chưa xác minh, khác với “không hỗ trợ”. 〜までに là hạn hoàn tất; điền ngày/giờ và múi giờ thật trước khi gửi mẫu này.
7.3. Ghi chú dành cho BrSE
- Đừng dịch “4-bit model” thành “mọi phép tính 4-bit”: làm rõ trọng số, activation, KV và runtime để khách hàng hiểu đúng phạm vi tiết kiệm.
- Khi nói “nhanh”, tách TTFT, ITL và throughput; người dùng chờ token đầu khác với đội vận hành muốn phục vụ nhiều phiên.
- Báo kết quả cùng thiết bị, context, revision và hash artifact. Phân biệt hướng dẫn chưa chạy, số đo đồ chơi và bằng chứng nghiệm thu để tránh cam kết vượt dữ kiện.
Nguồn tham khảo và phạm vi kiểm chứng
Nguồn kỹ thuật được đọc trong lượt biên soạn ngày 18/10/2026; các trang nhánh master có thể thay đổi. Khi tái lập cần lưu commit cụ thể của runtime/exporter, không coi ngày đọc là version phần mềm.
- ggml, đặc tả GGUF: container, metadata và tensor.
- Lin và cộng sự, AWQ, bản paper v5, cùng repository chính chủ: activation-aware scaling và hệ thống TinyChat.
- Frantar và cộng sự, GPTQ, paper ICLR 2023, cùng repository chính chủ: mục tiêu tái tạo output lớp và bù sai số bằng thông tin bậc hai.
- llama.cpp, llama-quantize và llama-bench: cách tạo candidate, phạm vi phép đo prompt/generation.
- Tra Hán Việt qua Từ điển Hán Nôm: 量, 誤, 差, 遅; các âm và mục đã có được đối chiếu lại với Sổ tay của blog. Cách đọc/nghĩa tham khảo Gakken — 誤差, Shogakukan qua Kotobank — 保証 và Kotobank — 実機.
Ảnh hero và sơ đồ luồng là SVG tự vẽ dành cho bài, phát hành theo CC0 1.0; không sao chép hình của paper. Mã Python là mô phỏng số học độc lập. Lệnh quantize/benchmark LLM cần model và thiết bị riêng, chưa chạy trong lượt này, nên bài không công bố kết quả hiệu năng thực tế.
Âm Hán Việt của các chữ bổ sung được đối chiếu trực tiếp: 与, 両, 均, 小, 必, 断, 最, 末, 私, 端, 術, 記, 語, 足, 速, 選, 願.